Métodos de Machine Learning para Clasificación
Implementación de KNN, árboles decisión, SVM y ensembles para problemas de clasificación en Python.
En esta novena guía exploraremos los principales algoritmos de machine learning para problemas de clasificación. Estos métodos son fundamentales para resolver problemas económicos como clasificación de riesgo crediticio, predicción de comportamiento de consumidores, segmentación de mercados, entre otros.
1 Introducción al aprendizaje supervisado
1.1 Concepto fundamental
El aprendizaje supervisado es un tipo de machine learning donde el modelo aprende de datos etiquetados (con respuestas conocidas) para predecir etiquetas de nuevos datos.
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from matplotlib.colors import ListedColormap

# Scikit-learn
from sklearn.datasets import load_iris, make_classification
from sklearn.model_selection import train_test_split, cross_val_score
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import (confusion_matrix, classification_report,
                             roc_curve, auc, accuracy_score)

# Modelos
from sklearn.linear_model import LogisticRegression
from sklearn.neighbors import KNeighborsClassifier
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import RandomForestClassifier

# Visualización de árboles
from sklearn import tree

# Configuración
plt.style.use('seaborn-v0_8-darkgrid')
plt.rcParams['figure.figsize'] = (12, 6)
np.random.seed(42)

print("Librerías importadas exitosamente")
Librerías importadas exitosamente1.2 Tipos de problemas de clasificación
print("""
TIPOS DE PROBLEMAS DE CLASIFICACIÓN

1. CLASIFICACIÓN BINARIA
   - Dos clases posibles
   - Ejemplos económicos:
     * Aprobado/Rechazado (crédito)
     * Paga/No paga (incumplimiento)
     * Éxito/Fracaso (empresa)
     * Compra/No compra (marketing)

2. CLASIFICACIÓN MULTI-CLASE
   - Más de dos clases
   - Ejemplos económicos:
     * Clasificación de riesgo (AAA, AA, A, BBB, etc.)
     * Segmentación de clientes (bajo, medio, alto valor)
     * Categorías de productos
     * Niveles socioeconómicos (A, B, C, D, E)

3. CLASIFICACIÓN MULTI-ETIQUETA
   - Múltiples etiquetas simultáneas
   - Ejemplos económicos:
     * Características de consumidor (múltiples intereses)
     * Atributos de producto (múltiples categorías)
""")
TIPOS DE PROBLEMAS DE CLASIFICACIÓN

1. CLASIFICACIÓN BINARIA
   - Dos clases posibles
   - Ejemplos económicos:
     * Aprobado/Rechazado (crédito)
     * Paga/No paga (incumplimiento)
     * Éxito/Fracaso (empresa)
     * Compra/No compra (marketing)

2. CLASIFICACIÓN MULTI-CLASE
   - Más de dos clases
   - Ejemplos económicos:
     * Clasificación de riesgo (AAA, AA, A, BBB, etc.)
     * Segmentación de clientes (bajo, medio, alto valor)
     * Categorías de productos
     * Niveles socioeconómicos (A, B, C, D, E)

3. CLASIFICACIÓN MULTI-ETIQUETA
   - Múltiples etiquetas simultáneas
   - Ejemplos económicos:
     * Características de consumidor (múltiples intereses)
     * Atributos de producto (múltiples categorías)
1.3 Dataset de ejemplo: Iris
# Cargar dataset clásico
iris = load_iris()

# Crear DataFrame
df_iris = pd.DataFrame(
    data=iris.data,
    columns=iris.feature_names
)
df_iris['especie'] = iris.target
df_iris['especie_nombre'] = df_iris['especie'].map({
    0: 'Setosa',
    1: 'Versicolor',
    2: 'Virginica'
})

print("Dataset Iris:")
print(df_iris.head())
print(f"\nForma: {df_iris.shape}")
print(f"\nDistribución de especies:")
print(df_iris['especie_nombre'].value_counts())

# Visualizar (usar solo 2 características)
plt.figure(figsize=(10, 6))
for especie in df_iris['especie'].unique():
    mask = df_iris['especie'] == especie
    plt.scatter(
        df_iris.loc[mask, 'sepal length (cm)'],
        df_iris.loc[mask, 'sepal width (cm)'],
        label=df_iris.loc[mask, 'especie_nombre'].iloc[0],
        alpha=0.7,
        s=100
    )

plt.xlabel('Largo del sépalo (cm)')
plt.ylabel('Ancho del sépalo (cm)')
plt.title('Dataset Iris - Clasificación de especies')
plt.legend()
plt.grid(True, alpha=0.3)
plt.savefig('iris_scatter.png', dpi=300, bbox_inches='tight')
print("\nGráfico guardado como 'iris_scatter.png'")
Dataset Iris:
sepal length (cm) sepal width (cm) petal length (cm) petal width (cm) \
0 5.1 3.5 1.4 0.2
1 4.9 3.0 1.4 0.2
2 4.7 3.2 1.3 0.2
3 4.6 3.1 1.5 0.2
4 5.0 3.6 1.4 0.2
especie especie_nombre
0 0 Setosa
1 0 Setosa
2 0 Setosa
3 0 Setosa
4 0 Setosa
Forma: (150, 6)
Distribución de especies:
especie_nombre
Setosa 50
Versicolor 50
Virginica 50
Name: count, dtype: int64
Gráfico guardado como 'iris_scatter.png'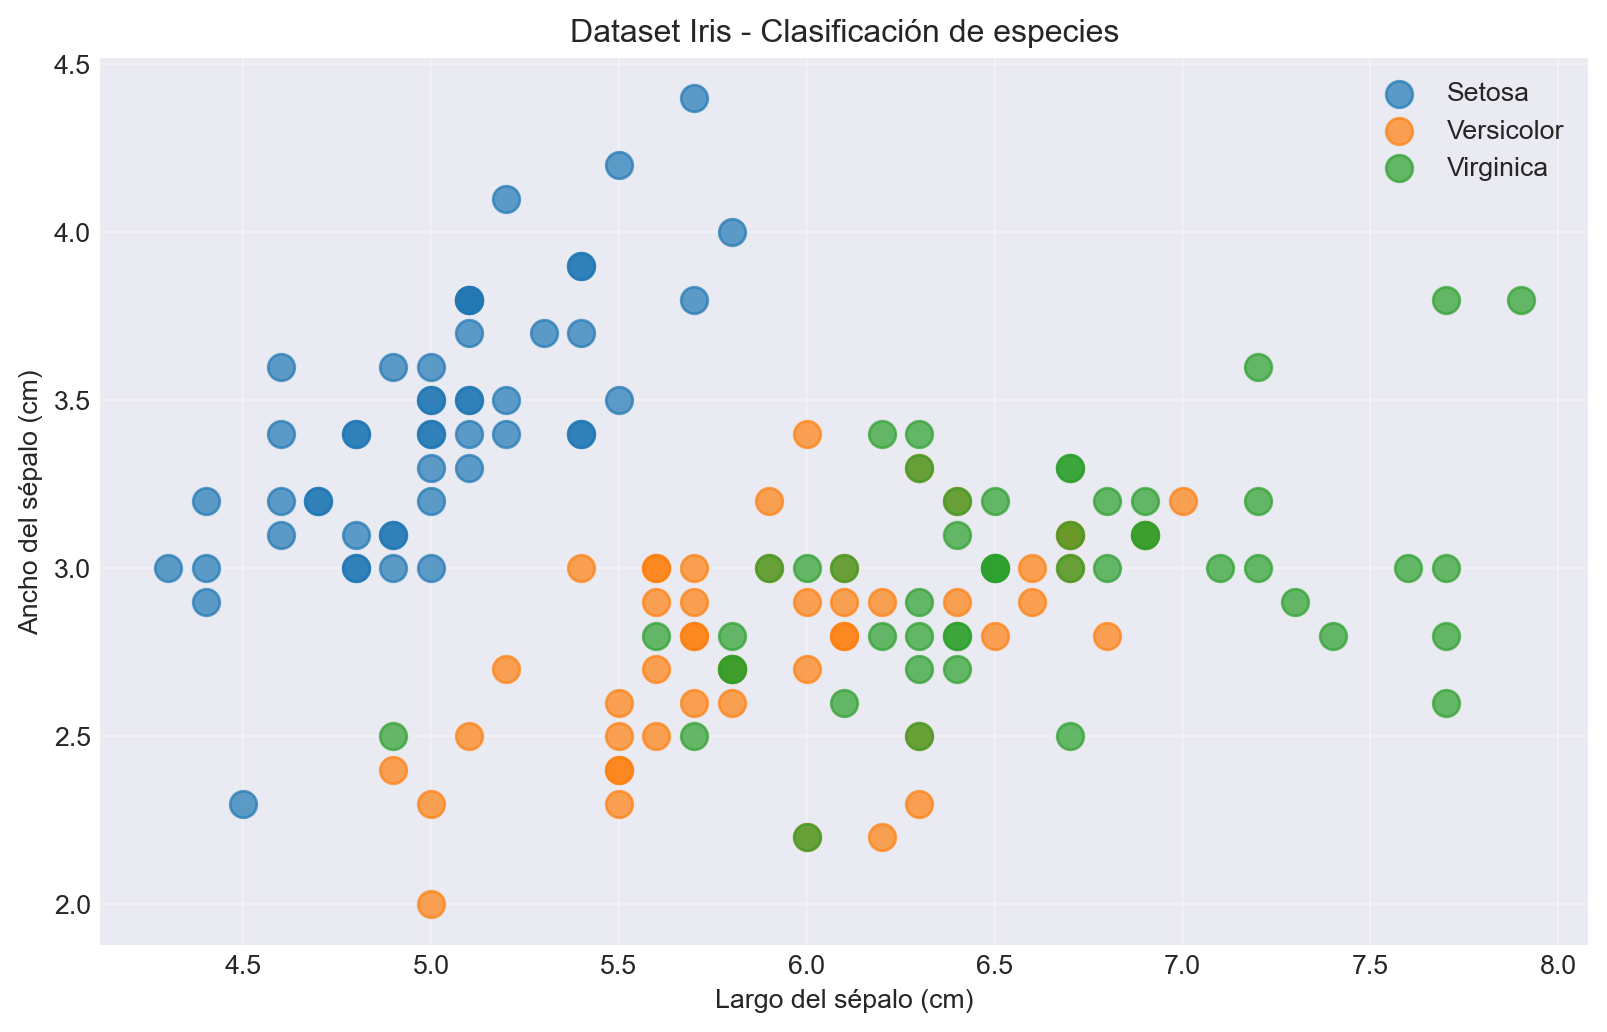
2 Regresión logística
2.1 Fundamento matemático
La regresión logística es uno de los métodos más fundamentales y ampliamente utilizados para problemas de clasificación binaria. A pesar de su nombre que incluye “regresión”, es un algoritmo de clasificación que predice probabilidades de pertenencia a clases mediante una transformación no lineal de una combinación lineal de características.
2.1.1 Modelo de probabilidad
Para clasificación binaria donde , la regresión logística modela la probabilidad de que la observación pertenezca a la clase positiva ():
Definiendo la combinación lineal:
La probabilidad se expresa como:
Esta función se conoce como función logística o sigmoide.
2.1.2 Función sigmoide
La función sigmoide tiene la forma:
Propiedades clave:
Rango: para todo
- Garantiza que las predicciones sean probabilidades válidas
Simetría:
Límites asintóticos:
Punto medio:
Derivada: Esta propiedad simplifica el cálculo de gradientes.
2.1.3 Odds y log-odds (logit)
Odds (momios):
La probabilidad de éxito sobre la probabilidad de fracaso:
Log-odds (logit):
Tomando logaritmo natural:
Esta es la transformación logit que convierte probabilidades (0,1) al rango completo de números reales .
Interpretación crucial: El modelo es lineal en el log-odds, no en la probabilidad misma.
2.1.4 Interpretación de coeficientes
Un incremento unitario en (manteniendo otras variables constantes):
En log-odds:
En odds:
- Si : → La variable incrementa el odds de
- Si : → La variable reduce el odds de
- Si : → La variable no afecta el odds
Efecto marginal en probabilidad:
El efecto no es constante; depende del nivel de probabilidad actual.
2.1.5 Estimación: Maximum Likelihood
Los coeficientes se estiman mediante máxima verosimilitud (MLE).
Log-verosimilitud:
Objetivo: Maximizar mediante métodos iterativos (Newton-Raphson, gradient descent).
Función de pérdida equivalente (Binary Cross-Entropy):
2.1.6 Frontera de decisión
La frontera de decisión es donde :
En el espacio de características, esta es una hipersuperficie lineal (hiperplano).
2.1.7 Ventajas
- Salidas probabilísticas interpretables
- Eficiencia computacional
- Pocos hiperparámetros
- Funciona bien como baseline
- Extensible a clasificación multi-clase
2.1.8 Limitaciones
- Asume linealidad en log-odds
- No captura relaciones no lineales complejas
- Sensible a outliers
- Requiere features relevantes
2.1.9 Aplicaciones económicas
- Predicción de incumplimiento crediticio
- Participación laboral
- Decisiones de compra
- Migración
- Adopción de tecnología
- Éxito de startups
2.2 Implementación
# Preparar datos (clasificación binaria: Virginica vs resto)
X = iris.data[:, :2]  # Solo usar 2 características para visualización
y = (iris.target == 2).astype(int)  # 1 si es Virginica, 0 si no

# Dividir datos
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42
)

print(f"Conjunto de entrenamiento: {X_train.shape[0]} muestras")
print(f"Conjunto de prueba: {X_test.shape[0]} muestras")
print(f"\nDistribución en entrenamiento:")
print(f"  Clase 0 (No Virginica): {(y_train == 0).sum()}")
print(f"  Clase 1 (Virginica): {(y_train == 1).sum()}")

# Entrenar modelo
modelo_logit = LogisticRegression(random_state=42)
modelo_logit.fit(X_train, y_train)

print(f"\n\nMODELO ENTRENADO")
print("=" * 70)
print(f"Intercepto (β₀): {modelo_logit.intercept_[0]:.4f}")
print(f"Coeficientes:")
print(f"  β₁ (largo sépalo): {modelo_logit.coef_[0, 0]:.4f}")
print(f"  β₂ (ancho sépalo): {modelo_logit.coef_[0, 1]:.4f}")
Conjunto de entrenamiento: 105 muestras
Conjunto de prueba: 45 muestras
Distribución en entrenamiento:
Clase 0 (No Virginica): 68
Clase 1 (Virginica): 37
MODELO ENTRENADO
======================================================================
Intercepto (β₀): -12.3391
Coeficientes:
β₁ (largo sépalo): 2.0623
β₂ (ancho sépalo): -0.20432.3 Predicción e interpretación
# Predecir probabilidades
probs_train = modelo_logit.predict_proba(X_train)[:, 1]
probs_test = modelo_logit.predict_proba(X_test)[:, 1]

# Predecir clases
y_pred = modelo_logit.predict(X_test)

# Evaluar
accuracy = accuracy_score(y_test, y_pred)
print(f"\nAccuracy en test: {accuracy:.4f} ({accuracy*100:.1f}%)")

# Matriz de confusión
cm = confusion_matrix(y_test, y_pred)
print(f"\nMatriz de confusión:")
print(cm)

# Reporte de clasificación
print(f"\nReporte de clasificación:")
print(classification_report(y_test, y_pred,
                          target_names=['No Virginica', 'Virginica']))

# Ejemplo de predicción
ejemplo = np.array([[6.5, 3.0]])  # Nuevo ejemplo
prob = modelo_logit.predict_proba(ejemplo)[0, 1]
pred = modelo_logit.predict(ejemplo)[0]

print(f"\n\nEJEMPLO DE PREDICCIÓN")
print(f"Características: Largo={ejemplo[0, 0]} cm, Ancho={ejemplo[0, 1]} cm")
print(f"Probabilidad de ser Virginica: {prob:.4f} ({prob*100:.1f}%)")
print(f"Predicción: {'Virginica' if pred == 1 else 'No Virginica'}")
Accuracy en test: 0.8667 (86.7%)

Matriz de confusión:
[[28  4]
 [ 2 11]]

Reporte de clasificación:
              precision    recall  f1-score   support

No Virginica       0.93      0.88      0.90        32
   Virginica       0.73      0.85      0.79        13

    accuracy                           0.87        45
   macro avg       0.83      0.86      0.84        45
weighted avg       0.88      0.87      0.87        45


EJEMPLO DE PREDICCIÓN
Características: Largo=6.5 cm, Ancho=3.0 cm
Probabilidad de ser Virginica: 0.6113 (61.1%)
Predicción: Virginica
2.4 Visualización del modelo
def plot_decision_boundary(modelo, X, y, title, filename):
    """Visualiza la frontera de decisión del modelo"""

    h = 0.02  # Tamaño del paso en la malla

    # Crear malla
    x_min, x_max = X[:, 0].min() - 0.5, X[:, 0].max() + 0.5
    y_min, y_max = X[:, 1].min() - 0.5, X[:, 1].max() + 0.5
    xx, yy = np.meshgrid(np.arange(x_min, x_max, h),
                         np.arange(y_min, y_max, h))

    # Predecir para cada punto en la malla
    Z = modelo.predict_proba(np.c_[xx.ravel(), yy.ravel()])[:, 1]
    Z = Z.reshape(xx.shape)

    # Graficar
    plt.figure(figsize=(12, 8))

    # Contorno de probabilidades
    contour = plt.contourf(xx, yy, Z, levels=20, cmap='RdYlBu_r', alpha=0.6)
    plt.colorbar(contour, label='Probabilidad clase positiva')

    # Frontera de decisión (probabilidad = 0.5)
    plt.contour(xx, yy, Z, levels=[0.5], colors='black', linewidths=2)

    # Puntos de datos
    scatter = plt.scatter(X[:, 0], X[:, 1], c=y,
                         cmap='RdYlBu_r', edgecolors='black',
                         s=100, alpha=0.9)

    plt.xlabel('Largo del sépalo (cm)', fontsize=12)
    plt.ylabel('Ancho del sépalo (cm)', fontsize=12)
    plt.title(title, fontsize=14, fontweight='bold')
    plt.grid(True, alpha=0.3)

    plt.tight_layout()
    plt.savefig(filename, dpi=300, bbox_inches='tight')
    print(f"Gráfico guardado como '{filename}'")

# Visualizar
plot_decision_boundary(
    modelo_logit, X_train, y_train,
    'Regresión Logística - Frontera de Decisión',
    'logistic_regression_boundary.png'
)
Gráfico guardado como 'logistic_regression_boundary.png'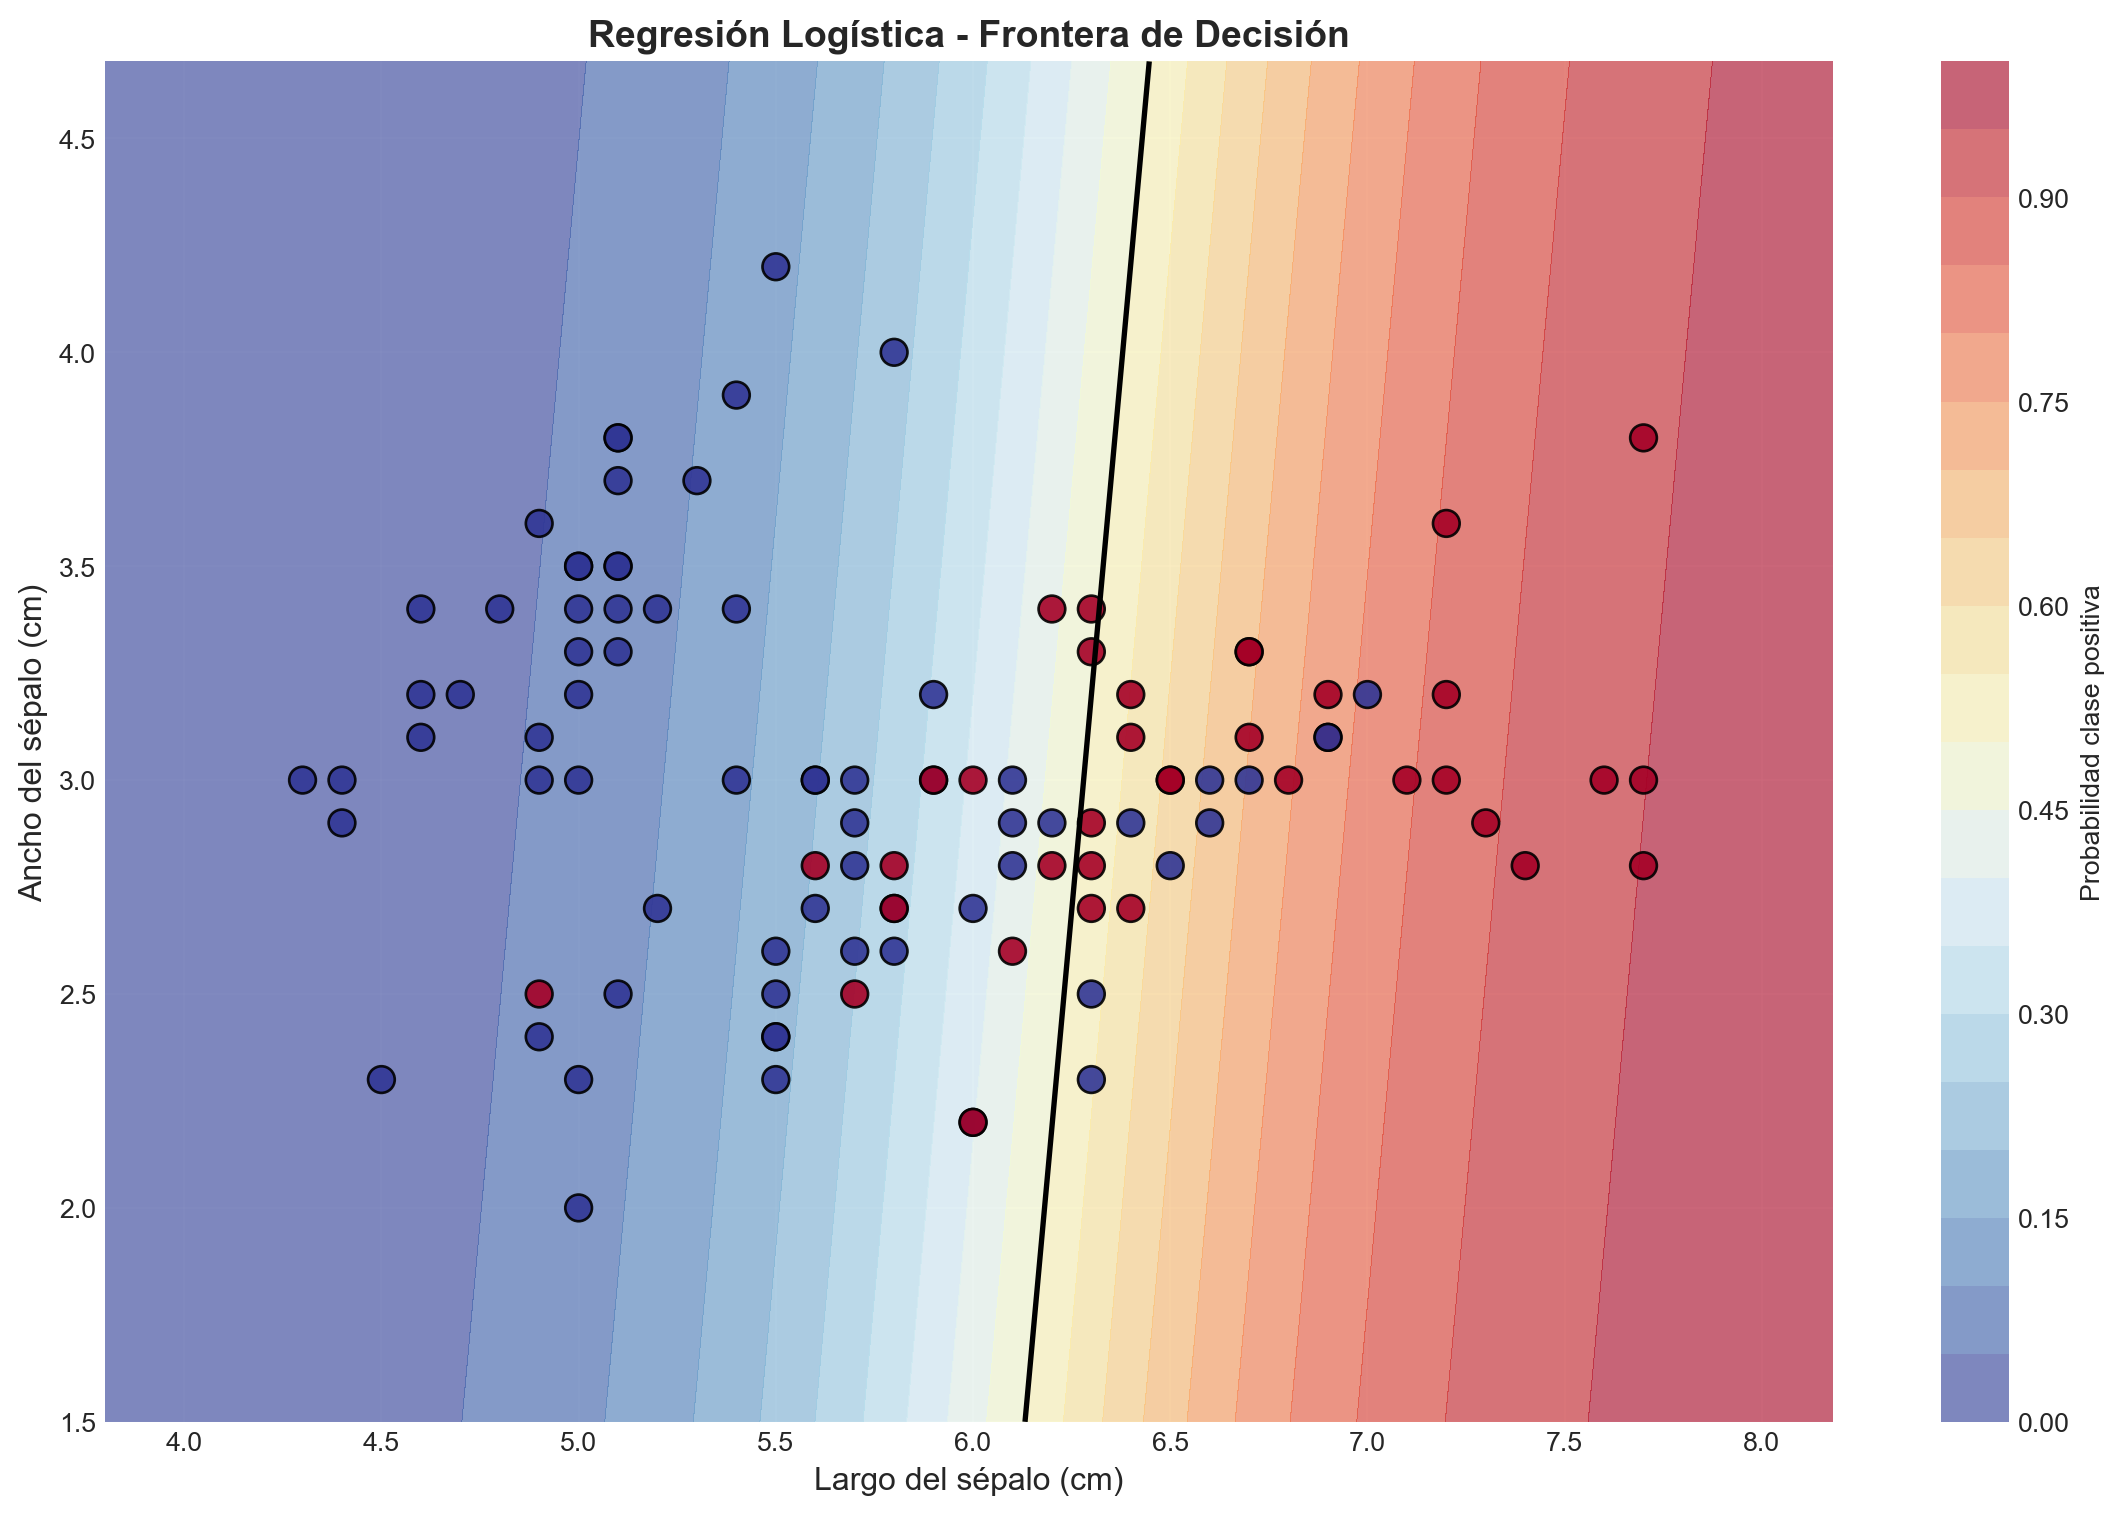
3 K-Nearest Neighbors (KNN)
3.1 Fundamento del algoritmo
K-Nearest Neighbors es un algoritmo de clasificación no paramétrico basado en la premisa de que observaciones similares (vecinas) tienden a pertenecer a la misma clase. Es uno de los algoritmos más simples conceptualmente, pero sorprendentemente efectivo en muchas aplicaciones.
3.1.1 Principio fundamental
Idea central: “Dime quiénes son tus vecinos y te diré quién eres”
Una nueva observación se clasifica según la clase más común entre sus vecinos más cercanos en el espacio de características.
3.1.2 Definición formal
Dado:
- Conjunto de entrenamiento
- Nuevo punto a clasificar
- Número de vecinos
El algoritmo:
Calcular distancias a todos los puntos de entrenamiento:
Identificar los puntos con menores distancias:
Votar por mayoría:
donde es la función indicadora y recorre todas las clases posibles.
3.1.3 Métricas de distancia
La elección de la métrica de distancia es fundamental en KNN:
1. Distancia Euclidiana (la más común):
2. Distancia Manhattan (city-block):
3. Distancia Minkowski (generalización):
donde:
- : Manhattan
- : Euclidiana
- : Chebyshev
4. Distancia de Mahalanobis (considera correlaciones):
3.1.4 Regla de decisión probabilística
KNN puede proporcionar probabilidades estimadas:
Es decir, la proporción de vecinos que pertenecen a la clase .
3.1.5 Versión ponderada
En lugar de votos iguales, se pueden usar pesos inversamente proporcionales a la distancia:
donde:
evita división por cero. Vecinos más cercanos tienen más influencia.
3.1.6 Parámetro k: Trade-off sesgo-varianza
k pequeño (ej: k=1):
- Baja bias: Frontera de decisión flexible, se adapta a detalles locales
- Alta varianza: Sensible a ruido, predicciones inestables
- Riesgo de overfitting
- Fronteras irregulares
k grande (ej: k=50):
- Alta bias: Frontera de decisión suave, ignora detalles locales
- Baja varianza: Predicciones estables
- Riesgo de underfitting
- Fronteras más regulares
k óptimo: Balance entre sesgo y varianza, determinado típicamente por validación cruzada.
3.1.7 Complejidad computacional
Búsqueda naive:
- Entrenamiento: (solo almacenar datos)
- Predicción: por cada nueva observación
- Calcular distancias de dimensión
- Encontrar los mínimos:
Total por predicción:
Estructuras eficientes (KD-trees, Ball trees):
- Construcción:
- Predicción: en promedio (mejor caso)
Sin embargo, en alta dimensionalidad ( grande), estas estructuras pierden eficiencia.
3.1.8 Maldición de la dimensionalidad
En espacios de alta dimensión, KNN sufre severamente:
Problema 1: Las distancias se vuelven uniformes
Todos los puntos parecen equidistantes, haciendo que el concepto de “vecino cercano” pierda significado.
Problema 2: Volumen crece exponencialmente
Para mantener densidad constante de vecinos, el volumen requerido crece como .
Consecuencia: KNN funciona mejor cuando .
3.1.9 Sensibilidad a la escala
KNN es extremadamente sensible a la escala de las variables.
Problema: Una variable con rango [0, 1000] dominará una con rango [0, 1] en el cálculo de distancias.
Solución obligatoria: Estandarización
Sin estandarización, el algoritmo es inválido.
3.1.10 Fronteras de decisión
Las fronteras de decisión de KNN son:
- No lineales: Pueden ser arbitrariamente complejas
- No paramétricas: No asumen forma funcional
- Locales: Definidas solo por vecinos cercanos
- Irregulares: Especialmente con k pequeño
Para clasificación binaria con k=1, la frontera es la diagrama de Voronoi del conjunto de entrenamiento.
3.1.11 Propiedades teóricas
Teorema (Cover & Hart, 1967):
Para k=1 y , el error de KNN está acotado por:
donde Error es el error del clasificador óptimo.
Consistencia: KNN es consistente si y cuando .
3.1.12 Ventajas
- Simplicidad conceptual: Muy intuitivo
- No paramétrico: No asume distribución de datos
- Flexibilidad: Captura fronteras complejas
- Lazy learning: No hay fase de entrenamiento
- Actualización trivial: Fácil incorporar nuevos datos
- Múltiples clases: Extiende naturalmente a clasificación multi-clase
3.1.13 Limitaciones
- Costo computacional alto en predicción: por cada predicción
- Sensibilidad a escala: Requiere estandarización obligatoria
- Maldición dimensionalidad: Falla en espacios de alta dimensión
- Memoria: Debe almacenar todo el conjunto de entrenamiento
- Sensibilidad a features irrelevantes: Variables ruidosas contaminan distancias
- No interpretable: No hay modelo explícito para interpretar
- Elección de k: Requiere validación cruzada
3.1.14 Selección del parámetro k
Validación cruzada:
Regla empírica:
Recomendación: Probar valores impares para evitar empates en clasificación binaria.
3.1.15 Extensiones y variantes
1. Weighted KNN: Pesos basados en distancia o kernel.
2. Distance-weighted KNN:
3. Adaptive KNN: Diferentes valores de para diferentes regiones del espacio.
4. Locally Weighted Learning: Combina KNN con regresión local.
3.1.16 Aplicaciones en economía
Sistemas de recomendación: Recomendar productos basados en consumidores similares
Credit scoring: Clasificar aplicantes basándose en aplicantes históricos similares
Detección de fraude: Identificar transacciones anómalas (diferentes de vecinos)
Valuación inmobiliaria: Precio de casas basado en propiedades similares
Segmentación de clientes: Agrupar clientes con características similares
Predicción de quiebra: Clasificar empresas basándose en empresas similares del pasado
3.1.17 Comparación con métodos paramétricos
| Aspecto | KNN | Métodos Paramétricos |
|---|---|---|
| Supuestos | Mínimos | Forma funcional específica |
| Interpretabilidad | Baja | Alta |
| Flexibilidad | Alta | Media-Baja |
| Costo computacional | Alto (predicción) | Bajo (predicción) |
| Dimensionalidad | Sufre con p alto | Mejor con regularización |
| Fronteras | No lineales complejas | Lineales o simples |
3.2 Implementación
# Estandarizar características (importante para KNN)
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# Entrenar modelos con diferentes valores de k
k_values = [1, 3, 5, 10, 15, 20]
resultados_knn = []

print("EVALUACIÓN DE KNN CON DIFERENTES VALORES DE K")
print("=" * 70)
print(f"{'K':<5} {'Accuracy Train':<15} {'Accuracy Test':<15} {'Diferencia':<12}")
print("-" * 70)

for k in k_values:
    # Entrenar modelo
    modelo_knn = KNeighborsClassifier(n_neighbors=k)
    modelo_knn.fit(X_train_scaled, y_train)

    # Evaluar
    acc_train = modelo_knn.score(X_train_scaled, y_train)
    acc_test = modelo_knn.score(X_test_scaled, y_test)
    diff = acc_train - acc_test

    resultados_knn.append({
        'k': k,
        'acc_train': acc_train,
        'acc_test': acc_test,
        'diff': diff
    })

    print(f"{k:<5} {acc_train:<15.4f} {acc_test:<15.4f} {diff:<12.4f}")

# Encontrar mejor k
df_knn = pd.DataFrame(resultados_knn)
mejor_k = df_knn.loc[df_knn['acc_test'].idxmax(), 'k']
print(f"\n\nMejor k: {int(mejor_k)} (mayor accuracy en test)")
EVALUACIÓN DE KNN CON DIFERENTES VALORES DE K
======================================================================
K Accuracy Train Accuracy Test Diferencia
----------------------------------------------------------------------
1 0.9619 0.7111 0.2508
3 0.8571 0.8000 0.0571
5 0.8667 0.8000 0.0667
10 0.8190 0.7556 0.0635
15 0.8381 0.7111 0.1270
20 0.8095 0.7556 0.0540
Mejor k: 3 (mayor accuracy en test)3.3 Visualización del efecto de k
# Entrenar modelo con mejor k
modelo_knn_final = KNeighborsClassifier(n_neighbors=int(mejor_k))
modelo_knn_final.fit(X_train_scaled, y_train)

# Graficar accuracy vs k
fig, axes = plt.subplots(1, 2, figsize=(15, 5))

# Accuracy
axes[0].plot(df_knn['k'], df_knn['acc_train'], 'o-',
             label='Training', linewidth=2, markersize=8)
axes[0].plot(df_knn['k'], df_knn['acc_test'], 's-',
             label='Test', linewidth=2, markersize=8)
axes[0].axvline(x=mejor_k, color='red', linestyle='--',
                label=f'Mejor k={int(mejor_k)}')
axes[0].set_xlabel('Número de vecinos (k)')
axes[0].set_ylabel('Accuracy')
axes[0].set_title('Accuracy vs K')
axes[0].legend()
axes[0].grid(True, alpha=0.3)

# Overfitting
axes[1].plot(df_knn['k'], df_knn['diff'], 'o-',
             linewidth=2, markersize=8, color='purple')
axes[1].axhline(y=0, color='black', linestyle='--', alpha=0.3)
axes[1].axvline(x=mejor_k, color='red', linestyle='--',
                label=f'Mejor k={int(mejor_k)}')
axes[1].set_xlabel('Número de vecinos (k)')
axes[1].set_ylabel('Train Accuracy - Test Accuracy')
axes[1].set_title('Diferencia Train-Test (Indicador de Overfitting)')
axes[1].legend()
axes[1].grid(True, alpha=0.3)

plt.tight_layout()
plt.savefig('knn_k_selection.png', dpi=300, bbox_inches='tight')
print("\nGráfico guardado como 'knn_k_selection.png'")
Gráfico guardado como 'knn_k_selection.png'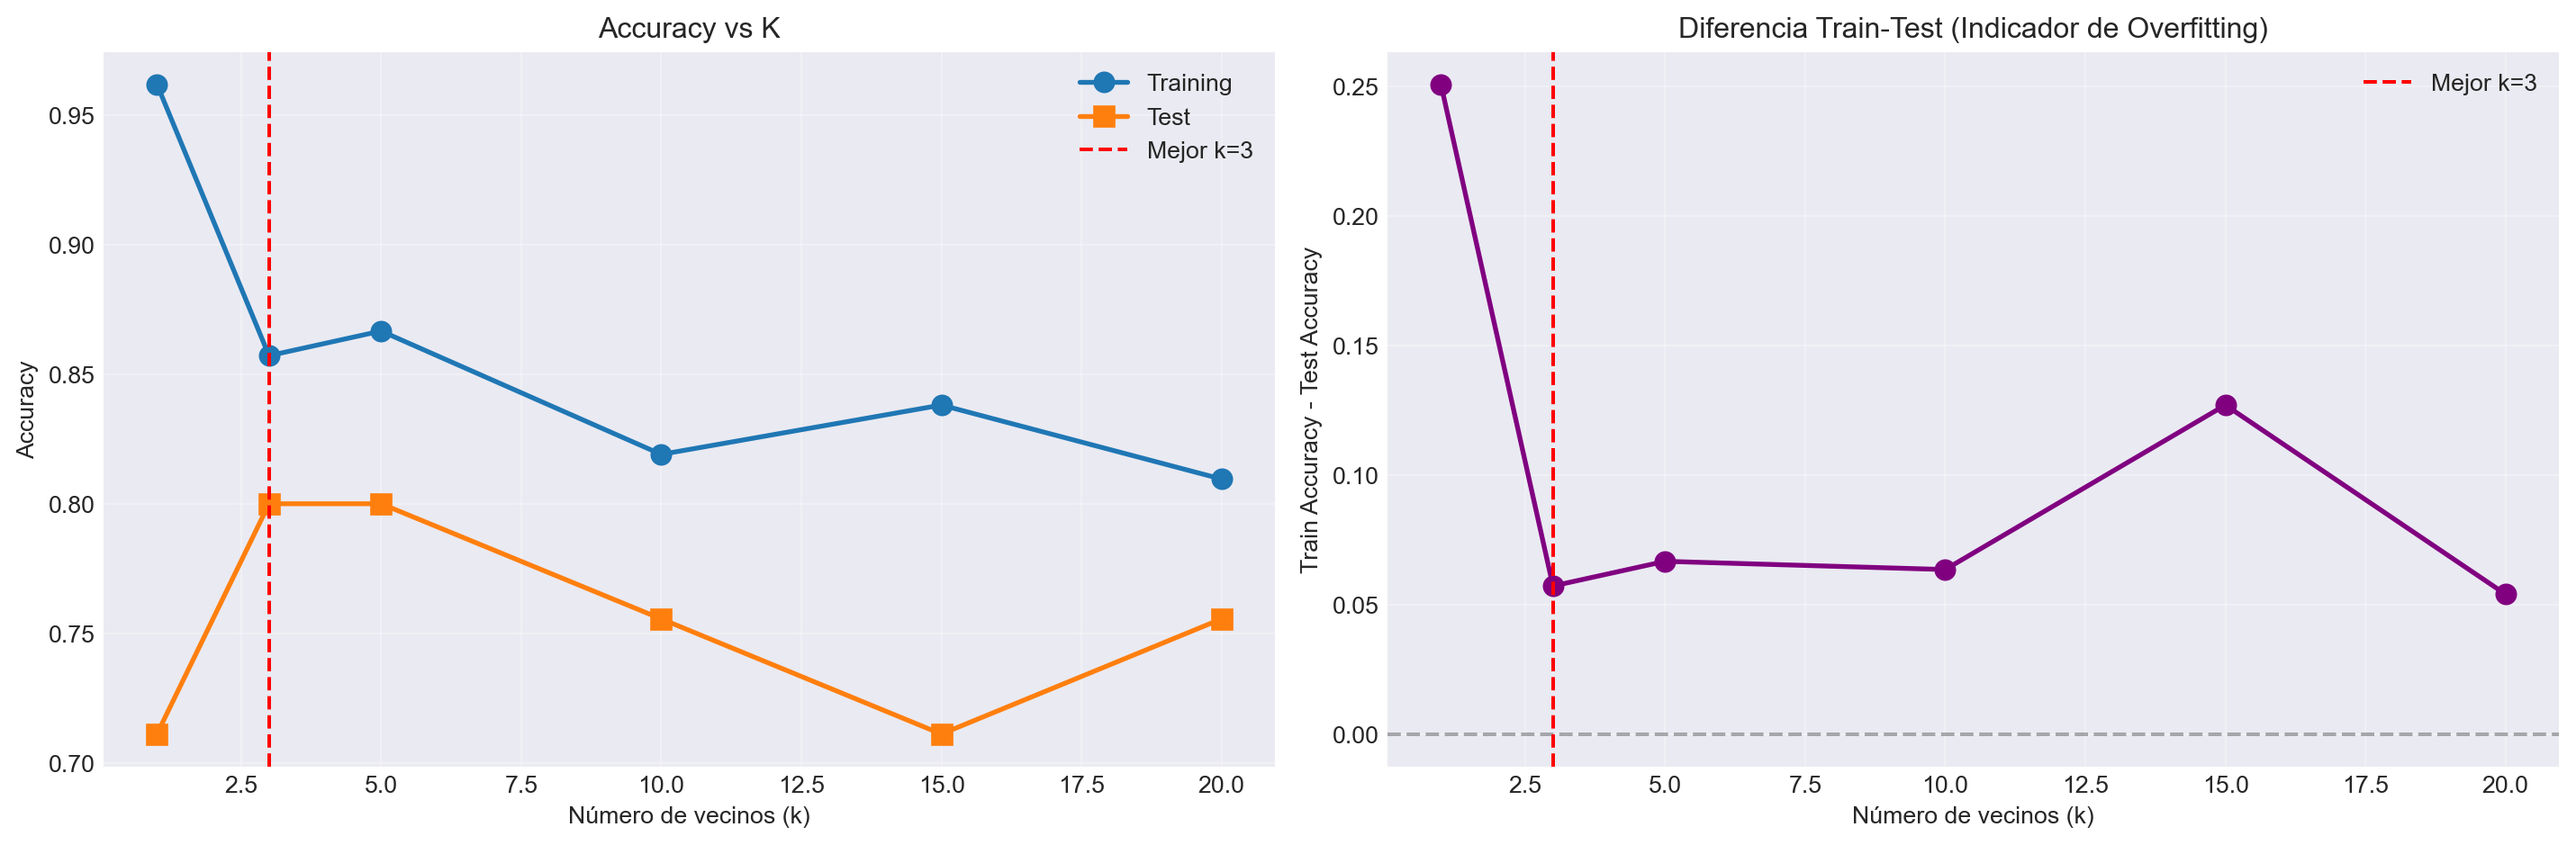
3.4 Visualización de fronteras de decisión
# Comparar diferentes valores de k
fig, axes = plt.subplots(2, 3, figsize=(18, 12))
axes = axes.ravel()

h = 0.02
x_min, x_max = X_train_scaled[:, 0].min() - 1, X_train_scaled[:, 0].max() + 1
y_min, y_max = X_train_scaled[:, 1].min() - 1, X_train_scaled[:, 1].max() + 1
xx, yy = np.meshgrid(np.arange(x_min, x_max, h),
                     np.arange(y_min, y_max, h))

for idx, k in enumerate([1, 3, 5, 10, 15, 20]):
    # Entrenar modelo
    knn = KNeighborsClassifier(n_neighbors=k)
    knn.fit(X_train_scaled, y_train)

    # Predecir
    Z = knn.predict(np.c_[xx.ravel(), yy.ravel()])
    Z = Z.reshape(xx.shape)

    # Graficar
    axes[idx].contourf(xx, yy, Z, alpha=0.4, cmap='RdYlBu_r')
    axes[idx].scatter(X_train_scaled[:, 0], X_train_scaled[:, 1],
                     c=y_train, cmap='RdYlBu_r',
                     edgecolors='black', s=50)

    acc = knn.score(X_test_scaled, y_test)
    axes[idx].set_title(f'k={k}, Accuracy={acc:.3f}')
    axes[idx].set_xlabel('Feature 1 (escalado)')
    axes[idx].set_ylabel('Feature 2 (escalado)')
    axes[idx].grid(True, alpha=0.3)

plt.tight_layout()
plt.savefig('knn_comparison.png', dpi=300, bbox_inches='tight')
print("Comparación guardada como 'knn_comparison.png'")
Comparación guardada como 'knn_comparison.png'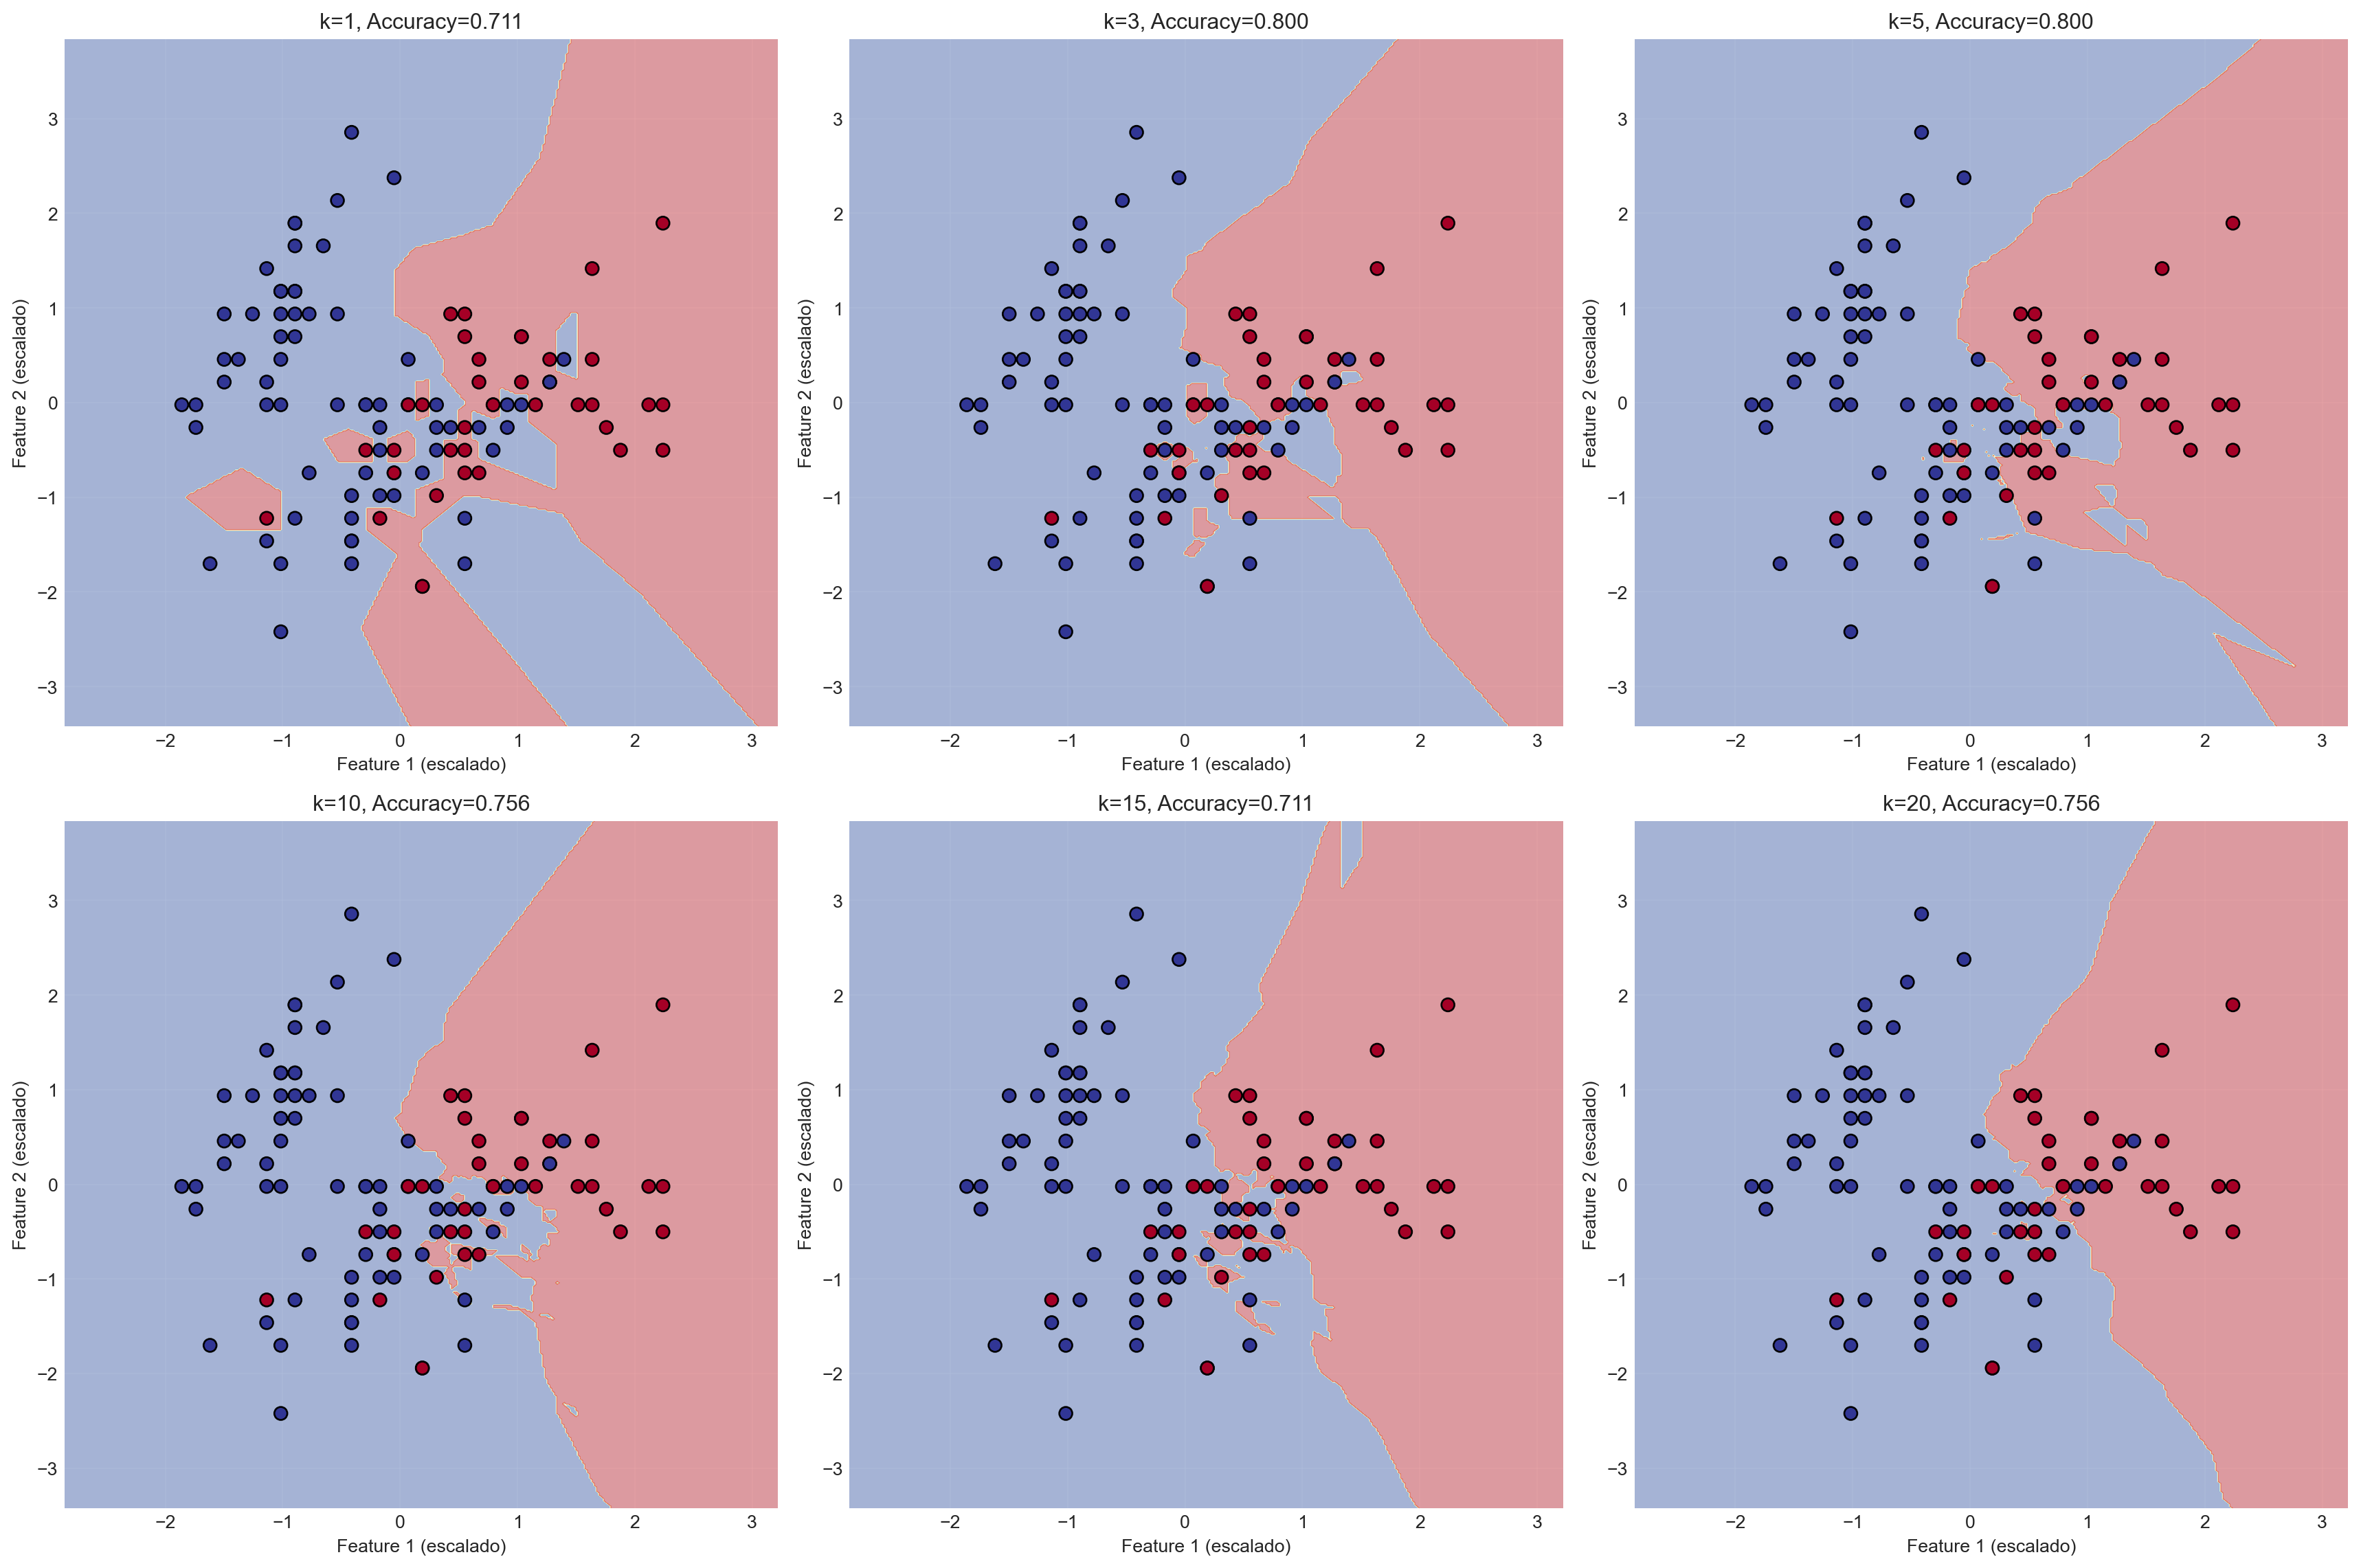
4 Árboles de decisión
4.1 Fundamento del algoritmo
Los árboles de decisión son modelos no paramétricos que segmentan recursivamente el espacio de características mediante reglas de decisión simples, creando una estructura jerárquica tipo árbol. Son altamente interpretables y capturan relaciones no lineales complejas.
4.1.1 Estructura del árbol
Un árbol de decisión consiste en:
Nodo raíz: Contiene todos los datos
Nodos internos: Representan decisiones basadas en características
- Test en una característica:
- División binaria del espacio
Hojas (nodos terminales): Contienen predicciones
- Clasificación: Clase mayoritaria en la hoja
- Probabilidad: Distribución empírica de clases
Ramas: Conectan nodos, representan resultados de tests
4.1.2 Algoritmo de construcción recursiva
El algoritmo CART (Classification and Regression Trees) construye el árbol mediante particiones binarias recursivas:
Paso 1 - Selección de división óptima:
Para cada nodo, encontrar la mejor división que minimiza una función de impureza:
donde:
- : Índice de característica
- : Umbral de división
- : Número de muestras en nodo izquierdo/derecho
- : Impureza de nodos hijo
Paso 2 - División:
Dividir datos según :
- Izquierda:
- Derecha:
Paso 3 - Recursión:
Repetir para cada nodo hijo hasta cumplir criterio de parada.
4.1.3 Criterios de impureza
1. Índice de Gini (Gini Impurity):
donde es la proporción de muestras de clase en el nodo .
Interpretación: Probabilidad de clasificar incorrectamente una observación aleatoria si se etiqueta aleatoriamente según distribución del nodo.
Propiedades:
- Mínimo: 0 (nodo puro, todas las muestras de una clase)
- Máximo: (distribución uniforme sobre clases)
- Para : Máximo en , Gini = 0.5
2. Entropía (Entropy):
(por convención, )
Interpretación: Cantidad promedio de información (en bits) necesaria para codificar la clase.
Propiedades:
- Mínimo: 0 (nodo puro)
- Máximo: (distribución uniforme)
- Para : Máximo en , Entropy = 1
Ganancia de información (Information Gain):
3. Error de clasificación:
Menos sensible que Gini y Entropy; menos usado en práctica.
4.1.4 Comparación Gini vs Entropy
Para clasificación binaria:
Diferencias:
- Entropy penaliza más desigualdades
- Gini es más rápido de calcular (no requiere logaritmo)
- En práctica, producen árboles similares
4.1.5 Criterios de parada
El proceso de división se detiene cuando:
Pureza perfecta: Todas las muestras en el nodo pertenecen a la misma clase
Profundidad máxima (
max_depth): Se alcanza profundidad especificadaMuestras mínimas para dividir (
min_samples_split):Muestras mínimas en hoja (
min_samples_leaf): División resultaría en hoja con menos muestras que umbralGanancia de información insuficiente (
min_impurity_decrease):Número de hojas máximo (
max_leaf_nodes): Se alcanza número especificado de hojas
4.1.6 Predicción
Para clasificar una nueva observación :
Paso 1: Comenzar en raíz
Paso 2: Seguir ramas según tests:
- Si : ir a nodo izquierdo
- Si : ir a nodo derecho
Paso 3: Al llegar a hoja, predecir:
Clase:
Probabilidad:
4.1.7 Fronteras de decisión
Las fronteras son hiperplanos perpendiculares a los ejes (axis-aligned):
- Cada división crea frontera perpendicular a un eje de característica
- Partición recursiva del espacio en regiones rectangulares
- Dentro de cada región: predicción constante
Limitación: No puede representar eficientemente fronteras oblicuas (ej: ).
4.1.8 Importancia de características
La importancia de característica se calcula como:
Suma ponderada de reducción de impureza sobre todos los nodos que usan .
Normalización:
4.1.9 Poda del árbol (Pruning)
Para controlar overfitting:
1. Pre-pruning (early stopping): Detener crecimiento usando criterios de parada estrictos
2. Post-pruning (pruning): Construir árbol completo, luego podar:
Cost-Complexity Pruning:
donde:
- : Error de clasificación del árbol
- : Número de hojas
- : Parámetro de complejidad
Seleccionar que minimiza error de validación cruzada.
4.1.10 Ventajas
Interpretabilidad: Fácil de entender y visualizar
No requiere preprocesamiento: No necesita estandarización ni normalización
Maneja datos mixtos: Características numéricas y categóricas
No paramétrico: No asume distribución de datos
Captura no linealidades: Automáticamente modela interacciones complejas
Robustez a outliers: En variables independientes (no en Y)
Selección implícita de features: Usa solo características informativas
Manejo de missing values: Algoritmos con estrategias para datos faltantes
4.1.11 Limitaciones
Overfitting: Tendencia a ajustar demasiado datos de entrenamiento
- Árboles profundos memorizan ruido
Inestabilidad: Alta varianza
- Pequeños cambios en datos → árbol completamente diferente
- No robusto
Sesgo con clases desbalanceadas: Tiende a favorecer clase mayoritaria
Fronteras axis-aligned: No eficiente para fronteras oblicuas
Greedy algorithm: Optimización local en cada división
- No garantiza árbol globalmente óptimo
Discontinuidades: Predicciones cambian abruptamente en fronteras
4.1.12 Hiperparámetros principales
| Parámetro | Descripción | Efecto |
|---|---|---|
max_depth |
Profundidad máxima | Mayor → Más complejo, overfitting |
min_samples_split |
Muestras mínimas para dividir | Mayor → Más simple |
min_samples_leaf |
Muestras mínimas en hoja | Mayor → Más suave |
max_features |
Features a considerar | Menor → Más diversidad |
max_leaf_nodes |
Número máximo de hojas | Menor → Más simple |
min_impurity_decrease |
Ganancia mínima | Mayor → Más conservador |
4.1.13 Aplicaciones en economía
Credit scoring: Reglas claras para aprobación/rechazo de créditos
Segmentación de clientes: Identificar grupos con características similares
Detección de fraude: Reglas para identificar transacciones sospechosas
Predicción de churn: Identificar clientes en riesgo de abandonar
Pricing dinámico: Reglas para ajustar precios según características
Evaluación de riesgo: Clasificación de riesgo crediticio o empresarial
Decisiones de inversión: Reglas para compra/venta de activos
4.1.14 Comparación con otros métodos
| Aspecto | Decision Trees | Logistic Regression | KNN |
|---|---|---|---|
| Interpretabilidad | Alta | Media | Baja |
| Captura no linealidades | Sí | No (sin transformaciones) | Sí |
| Preprocesamiento | Mínimo | Requiere estandarización | Requiere estandarización |
| Overfitting | Alto | Bajo-Medio | Medio-Alto |
| Estabilidad | Baja | Alta | Media |
| Velocidad predicción | Rápida | Rápida | Lenta |
4.1.15 Extensiones y variantes
1. Árboles de regresión (CART): Predicción de valores continuos
2. Random Forests: Ensemble de árboles (siguiente sección)
3. Gradient Boosted Trees: Ensemble secuencial (XGBoost, LightGBM)
4. Conditional Inference Trees: Usa tests estadísticos para divisiones
5. Árboles multivariados: Divisiones oblicuas (no axis-aligned)
4.2 Implementación básica
# Entrenar árbol de decisión
modelo_tree = DecisionTreeClassifier(
    max_depth=3,
    min_samples_split=10,
    min_samples_leaf=5,
    random_state=42
)

modelo_tree.fit(X_train, y_train)

# Evaluar
y_pred_tree = modelo_tree.predict(X_test)
acc_tree = accuracy_score(y_test, y_pred_tree)

print("ÁRBOL DE DECISIÓN")
print("=" * 70)
print(f"Profundidad del árbol: {modelo_tree.get_depth()}")
print(f"Número de hojas: {modelo_tree.get_n_leaves()}")
print(f"Accuracy en test: {acc_tree:.4f} ({acc_tree*100:.1f}%)")

# Importancia de características
importancias = pd.DataFrame({
    'caracteristica': ['Largo sépalo', 'Ancho sépalo'],
    'importancia': modelo_tree.feature_importances_
}).sort_values('importancia', ascending=False)

print(f"\nImportancia de características:")
for _, row in importancias.iterrows():
    print(f"  {row['caracteristica']}: {row['importancia']:.4f}")
ÁRBOL DE DECISIÓN
======================================================================
Profundidad del árbol: 3
Número de hojas: 7
Accuracy en test: 0.8222 (82.2%)
Importancia de características:
Largo sépalo: 0.9006
Ancho sépalo: 0.09944.3 Visualización del árbol
# Visualizar árbol
plt.figure(figsize=(20, 10))
tree.plot_tree(
    modelo_tree,
    feature_names=['Largo sépalo', 'Ancho sépalo'],
    class_names=['No Virginica', 'Virginica'],
    filled=True,
    rounded=True,
    fontsize=10
)
plt.title('Árbol de Decisión - Clasificación de Iris',
          fontsize=16, fontweight='bold', pad=20)
plt.tight_layout()
plt.savefig('decision_tree.png', dpi=300, bbox_inches='tight')
print("\nÁrbol visualizado y guardado como 'decision_tree.png'")
Árbol visualizado y guardado como 'decision_tree.png'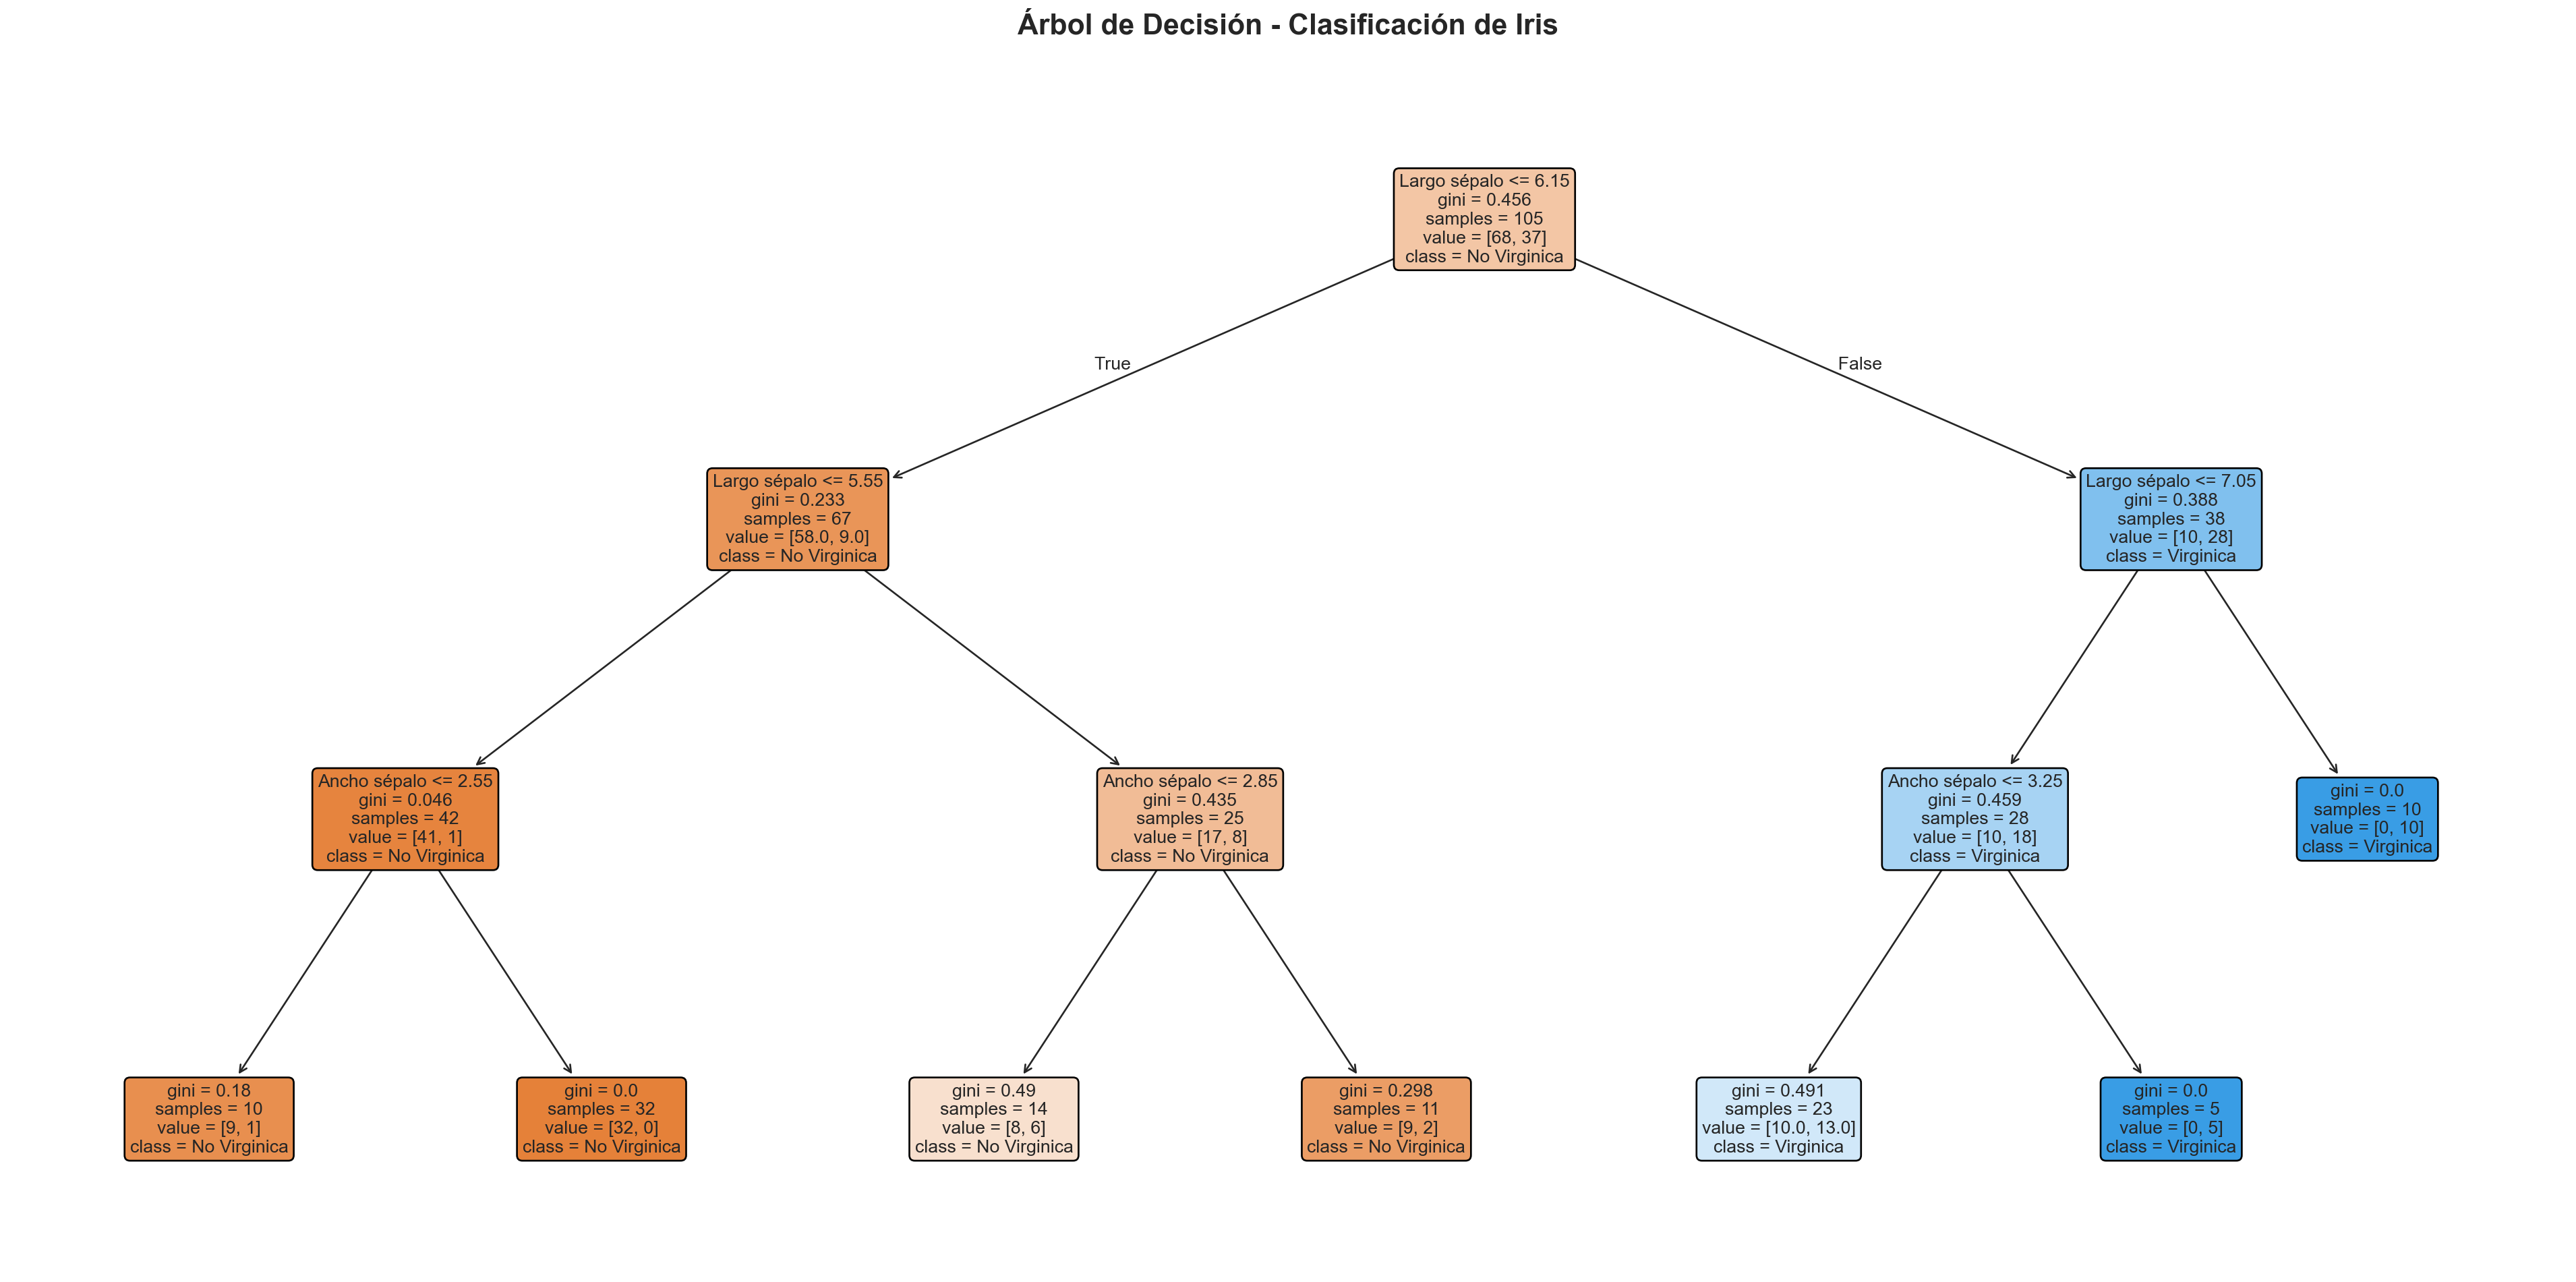
4.4 Efecto de la profundidad
# Evaluar diferentes profundidades
profundidades = range(1, 11)
resultados_depth = []

print("\n\nEFECTO DE LA PROFUNDIDAD DEL ÁRBOL")
print("=" * 70)
print(f"{'Profundidad':<12} {'Accuracy Train':<15} {'Accuracy Test':<15} {'Hojas':<10}")
print("-" * 70)

for depth in profundidades:
    tree_model = DecisionTreeClassifier(max_depth=depth, random_state=42)
    tree_model.fit(X_train, y_train)

    acc_train = tree_model.score(X_train, y_train)
    acc_test = tree_model.score(X_test, y_test)
    n_hojas = tree_model.get_n_leaves()

    resultados_depth.append({
        'depth': depth,
        'acc_train': acc_train,
        'acc_test': acc_test,
        'n_leaves': n_hojas
    })

    print(f"{depth:<12} {acc_train:<15.4f} {acc_test:<15.4f} {n_hojas:<10}")

# Graficar
df_depth = pd.DataFrame(resultados_depth)

fig, axes = plt.subplots(1, 2, figsize=(15, 5))

# Accuracy
axes[0].plot(df_depth['depth'], df_depth['acc_train'],
             'o-', label='Training', linewidth=2)
axes[0].plot(df_depth['depth'], df_depth['acc_test'],
             's-', label='Test', linewidth=2)
axes[0].set_xlabel('Profundidad máxima')
axes[0].set_ylabel('Accuracy')
axes[0].set_title('Accuracy vs Profundidad del Árbol')
axes[0].legend()
axes[0].grid(True, alpha=0.3)

# Complejidad
axes[1].plot(df_depth['depth'], df_depth['n_leaves'],
             'o-', color='green', linewidth=2)
axes[1].set_xlabel('Profundidad máxima')
axes[1].set_ylabel('Número de hojas')
axes[1].set_title('Complejidad del Árbol')
axes[1].grid(True, alpha=0.3)

plt.tight_layout()
plt.savefig('tree_depth_analysis.png', dpi=300, bbox_inches='tight')
print("\nAnálisis guardado como 'tree_depth_analysis.png'")
EFECTO DE LA PROFUNDIDAD DEL ÁRBOL
======================================================================
Profundidad  Accuracy Train  Accuracy Test   Hojas
----------------------------------------------------------------------
1            0.8190          0.8222          2
2            0.8381          0.7778          4
3            0.8476          0.7556          7
4            0.8476          0.7556          11
5            0.8667          0.7556          15
6            0.8762          0.7556          19
7            0.9333          0.7333          24
8            0.9429          0.7333          28
9            0.9429          0.7333          32
10           0.9619          0.6889          35

Análisis guardado como 'tree_depth_analysis.png'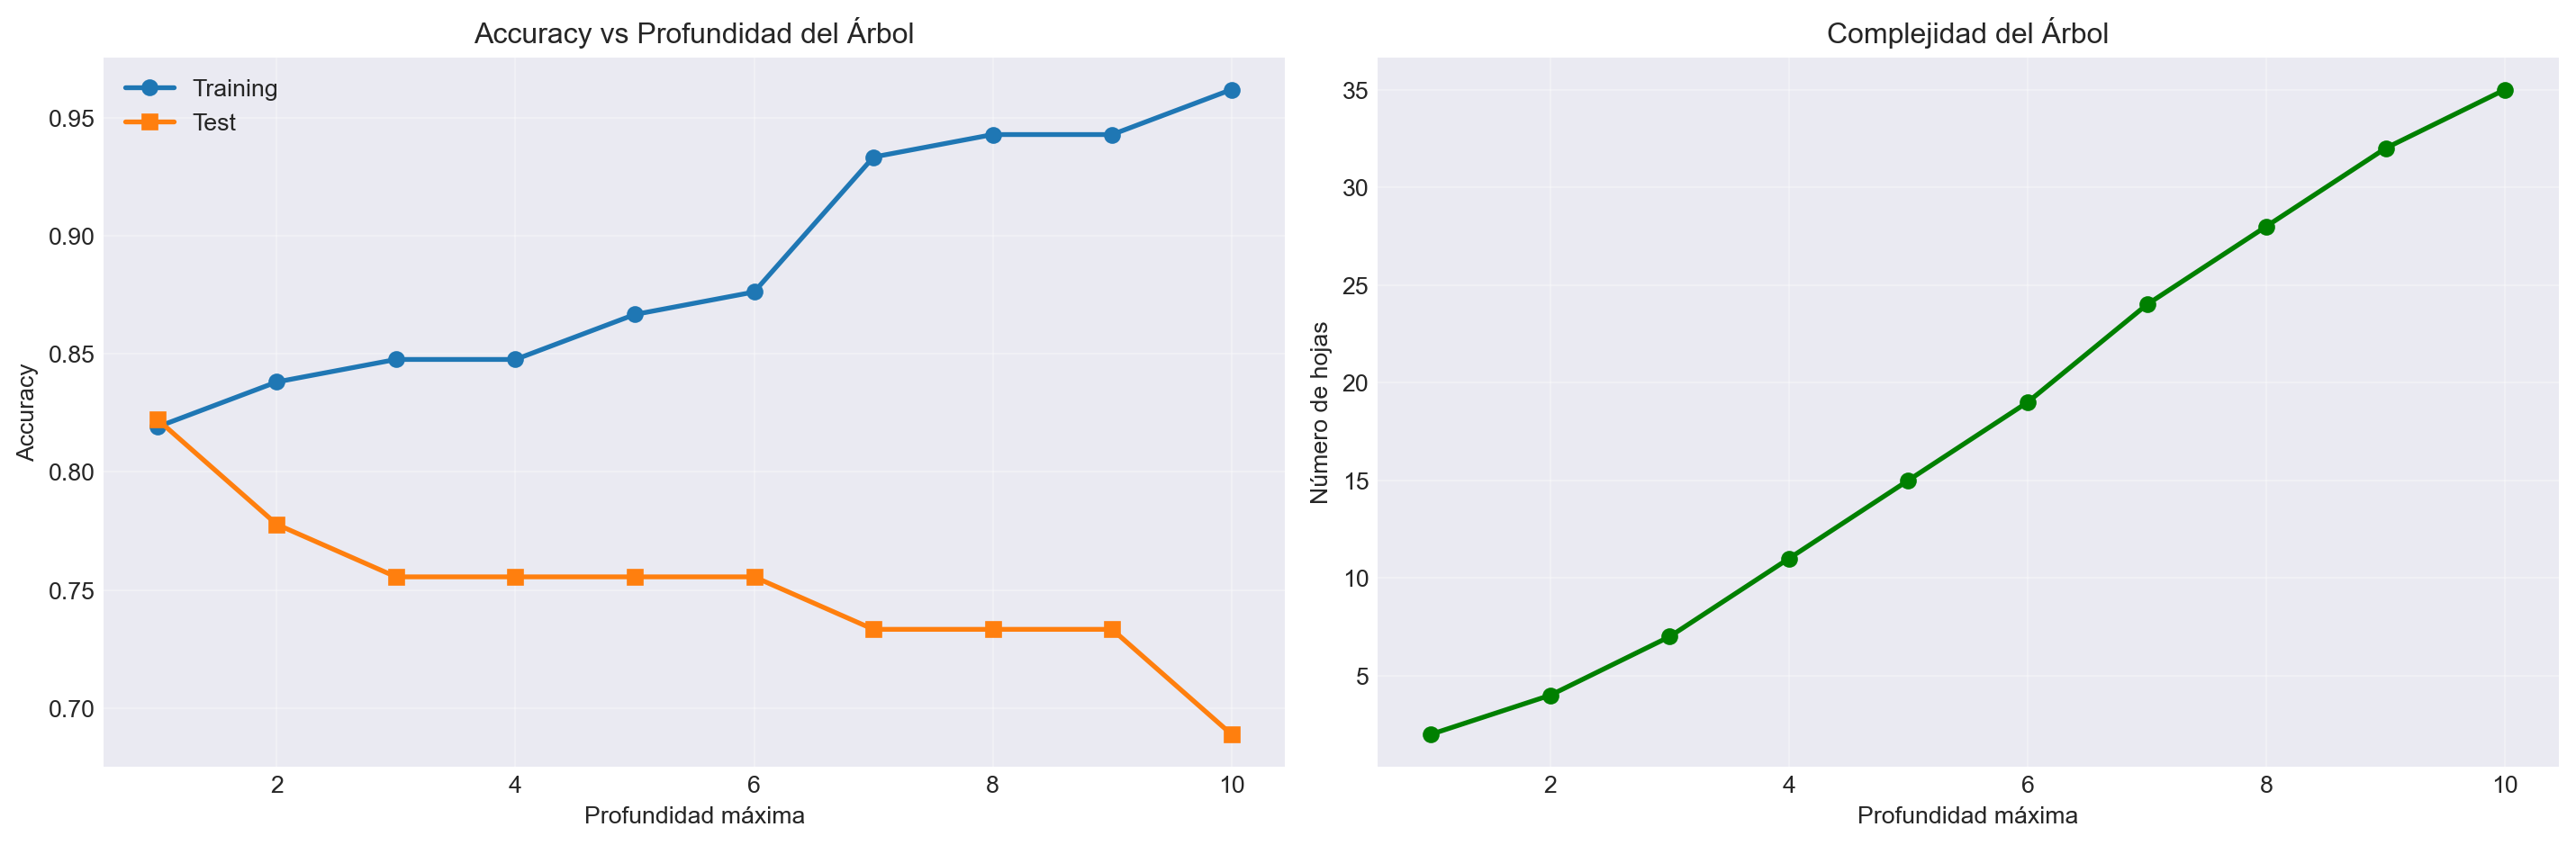
5 Random Forests
5.1 Fundamento del algoritmo
Random Forests (Bosques Aleatorios) es un método de ensemble que combina múltiples árboles de decisión para producir un clasificador más robusto y preciso. Fue propuesto por Leo Breiman en 2001 y se basa en el principio de “la sabiduría de las multitudes”.
5.1.1 Concepto central: Ensemble Learning
Idea fundamental: Combinar predicciones de múltiples modelos débiles para crear un modelo fuerte.
Analogía: Consultar a múltiples expertos y promediar sus opiniones suele dar mejor resultado que confiar en uno solo.
5.1.2 Algoritmo Random Forest
Entrada:
- Dataset
- Número de árboles
- Número de características por división
Proceso:
Para :
Paso 1 - Bootstrap: Crear muestra aleatoria con reemplazo
Aproximadamente 63.2% de observaciones únicas en cada muestra (algunas repetidas, otras excluidas).
Paso 2 - Entrenar árbol con randomización adicional:
Para cada nodo del árbol :
- Seleccionar aleatoriamente características de las disponibles
- Encontrar mejor división usando solo estas características
- Dividir nodo
- Repetir recursivamente
Paso 3 - Crecer árbol completo: Sin poda (o con poda mínima). Cada árbol tiene alta varianza pero bajo sesgo.
Predicción:
Para nueva observación :
Clasificación (votación mayoritaria):
Probabilidad:
5.1.3 Dos fuentes de aleatoriedad
Random Forests introduce dos niveles de aleatoriedad:
1. Bootstrap (Bagging):
- Diferentes muestras de entrenamiento para cada árbol
- Reduce varianza al promediar predictores correlacionados
2. Random Feature Selection:
- Diferentes subsets de características en cada división
- Decorrelaciona los árboles
- Típicamente para clasificación
Sin (2), los árboles serían muy similares (correlacionados), y el promedio no reduciría tanto la varianza.
5.1.4 Relación con Bagging
Bagging (Bootstrap Aggregating): Caso especial de Random Forest donde
Random Forest = Bagging + Random Feature Selection
La selección aleatoria de features es la innovación clave que mejora Bagging.
5.1.5 Out-of-Bag (OOB) Error
Para cada árbol , aproximadamente 37% de observaciones no están en .
Estas observaciones Out-of-Bag pueden usarse como conjunto de validación interno:
donde es el conjunto de árboles que no usaron observación .
Ventaja: No requiere conjunto de validación separado.
5.1.6 Importancia de características
Random Forests calcula dos medidas de importancia:
1. Mean Decrease Impurity (MDI):
Promedio sobre todos los árboles de la reducción de impureza cuando se usa .
2. Mean Decrease Accuracy (MDA) (Permutation Importance):
Para cada característica :
- Calcular OOB error original
- Permutar aleatoriamente valores de en OOB
- Recalcular OOB error
- Importancia = Incremento en error
Interpretación: Si es importante, permutarla aumentará significativamente el error.
5.1.7 Propiedades teóricas
Teorema (Breiman):
Bajo ciertas condiciones, cuando :
donde:
- : Correlación promedio entre árboles
- : Varianza promedio de cada árbol
- : Fuerza promedio de cada árbol
Implicaciones:
- Aumentar B: Siempre ayuda (no overfitting)
- Reducir ρ (decorrelación): Ayuda → Random feature selection
- Aumentar fuerza árboles: Ayuda → Usar más características
5.1.8 Hiperparámetros principales
| Parámetro | Descripción | Valor típico | Efecto |
|---|---|---|---|
n_estimators |
Número de árboles | 100-500 | Más = mejor (con límite) |
max_features |
Features por división | (clasificación) | Controla correlación |
max_depth |
Profundidad máxima | None (completo) | Controla sesgo-varianza |
min_samples_split |
Mínimo para dividir | 2 | Mayor = más simple |
min_samples_leaf |
Mínimo en hoja | 1 | Mayor = más suave |
bootstrap |
Usar bootstrap | True | False = usar todo dataset |
5.1.9 Ventajas
Reduce overfitting: Vs árbol único, por promediado
Alta precisión: Entre los mejores algoritmos out-of-the-box
Robusto: Menos sensible a hiperparámetros que otros métodos
Maneja alta dimensionalidad: Funciona bien incluso con grande
Importancia de features: Proporciona ranking de características
No requiere estandarización: Como árboles individuales
Paralelizable: Árboles se entrenan independientemente
OOB error: Validación interna sin conjunto separado
Maneja missing values: Estrategias incorporadas
Versátil: Funciona bien en diversos problemas
5.1.10 Limitaciones
Menos interpretable: Difícil entender modelo (caja negra)
Costo computacional:
- Entrenamiento:
- Predicción: Más lento que un árbol único
Memoria: Requiere almacenar árboles
Extrapolación limitada: No predice fuera del rango de datos de entrenamiento
Sesgo con clases desbalanceadas: Puede favorecer clase mayoritaria
No captura tendencias lineales simples: A veces un modelo simple es mejor
5.1.11 Comparación con otros métodos
| Aspecto | Random Forest | Decision Tree | Gradient Boosting |
|---|---|---|---|
| Interpretabilidad | Baja | Alta | Baja |
| Accuracy | Alta | Media | Muy alta |
| Overfitting | Bajo | Alto | Medio (con tuning) |
| Velocidad entrenamiento | Media | Rápida | Lenta |
| Velocidad predicción | Media | Rápida | Media |
| Hiperparámetros | Pocos críticos | Pocos | Muchos críticos |
| Robustez | Alta | Baja | Media |
5.1.12 Selección de hiperparámetros
Estrategia típica:
n_estimators: Comenzar con 100, aumentar hasta que performance se estabilice
max_features:
- Clasificación:
- Regresión:
- Probar también y
max_depth: Comenzar sin límite, reducir si overfitting
min_samples_split y min_samples_leaf: Usar valores por defecto inicialmente
Grid Search sobre:
n_estimators: [50, 100, 200, 500]max_features: [‘sqrt’, ‘log2’, 0.3]max_depth: [None, 10, 20, 30]min_samples_split: [2, 5, 10]
5.1.13 Aplicaciones en economía
Credit scoring: Predicción de incumplimiento con alta precisión
Predicción de precios:
- Inmuebles
- Acciones
- Commodities
Detección de fraude: Identificar transacciones fraudulentas
Churn prediction: Predecir abandono de clientes
Segmentación avanzada: Clasificar clientes en múltiples categorías
Predicción de quiebra empresarial: Clasificación de riesgo
Trading algorítmico: Señales de compra/venta
Risk management: Evaluación de riesgo de portafolios
5.1.14 Variantes y extensiones
1. Extremely Randomized Trees (Extra Trees):
- Divisiones completamente aleatorias (no optimizadas)
- Más rápido, más diversidad
2. Balanced Random Forest:
- Balanceo de clases en cada árbol
- Mejor para datasets desbalanceados
3. Isolation Forest:
- Para detección de anomalías
- Aísla outliers
4. Quantile Regression Forest:
- Predice distribución completa, no solo media
- Útil para intervalos de confianza
5.2 Implementación
# Entrenar Random Forest
modelo_rf = RandomForestClassifier(
    n_estimators=100,
    max_depth=5,
    min_samples_split=10,
    min_samples_leaf=5,
    random_state=42,
    n_jobs=-1  # Usar todos los procesadores
)

modelo_rf.fit(X_train, y_train)

# Evaluar
y_pred_rf = modelo_rf.predict(X_test)
acc_rf = accuracy_score(y_test, y_pred_rf)

print("RANDOM FOREST")
print("=" * 70)
print(f"Número de árboles: {modelo_rf.n_estimators}")
print(f"Accuracy en test: {acc_rf:.4f} ({acc_rf*100:.1f}%)")

# Importancia de características
importancias_rf = pd.DataFrame({
    'caracteristica': ['Largo sépalo', 'Ancho sépalo'],
    'importancia': modelo_rf.feature_importances_,
    'std': np.std([tree.feature_importances_
                   for tree in modelo_rf.estimators_], axis=0)
}).sort_values('importancia', ascending=False)

print(f"\nImportancia de características:")
for _, row in importancias_rf.iterrows():
    print(f"  {row['caracteristica']}: {row['importancia']:.4f} (±{row['std']:.4f})")
RANDOM FOREST
======================================================================
Número de árboles: 100
Accuracy en test: 0.8222 (82.2%)
Importancia de características:
Largo sépalo: 0.7925 (±0.1558)
Ancho sépalo: 0.2075 (±0.1558)5.3 Efecto del número de árboles
# Evaluar diferentes números de árboles
n_trees_list = [1, 5, 10, 20, 50, 100, 200]
resultados_trees = []

print("\n\nEFECTO DEL NÚMERO DE ÁRBOLES")
print("=" * 70)
print(f"{'N Árboles':<12} {'Accuracy Train':<15} {'Accuracy Test':<15}")
print("-" * 70)

for n_trees in n_trees_list:
    rf = RandomForestClassifier(
        n_estimators=n_trees,
        max_depth=5,
        random_state=42
    )
    rf.fit(X_train, y_train)

    acc_train = rf.score(X_train, y_train)
    acc_test = rf.score(X_test, y_test)

    resultados_trees.append({
        'n_trees': n_trees,
        'acc_train': acc_train,
        'acc_test': acc_test
    })

    print(f"{n_trees:<12} {acc_train:<15.4f} {acc_test:<15.4f}")

# Graficar
df_trees = pd.DataFrame(resultados_trees)

plt.figure(figsize=(10, 6))
plt.plot(df_trees['n_trees'], df_trees['acc_train'],
         'o-', label='Training', linewidth=2, markersize=8)
plt.plot(df_trees['n_trees'], df_trees['acc_test'],
         's-', label='Test', linewidth=2, markersize=8)
plt.xlabel('Número de árboles')
plt.ylabel('Accuracy')
plt.title('Accuracy vs Número de Árboles en Random Forest')
plt.legend()
plt.grid(True, alpha=0.3)
plt.xscale('log')
plt.tight_layout()
plt.savefig('random_forest_ntrees.png', dpi=300, bbox_inches='tight')
print("\nGráfico guardado como 'random_forest_ntrees.png'")
EFECTO DEL NÚMERO DE ÁRBOLES
======================================================================
N Árboles    Accuracy Train  Accuracy Test
----------------------------------------------------------------------
1            0.8381          0.7111
5            0.8857          0.8000
10           0.8762          0.7556
20           0.8952          0.8000
50           0.8857          0.8000
100          0.8857          0.8000
200          0.8667          0.7778

Gráfico guardado como 'random_forest_ntrees.png'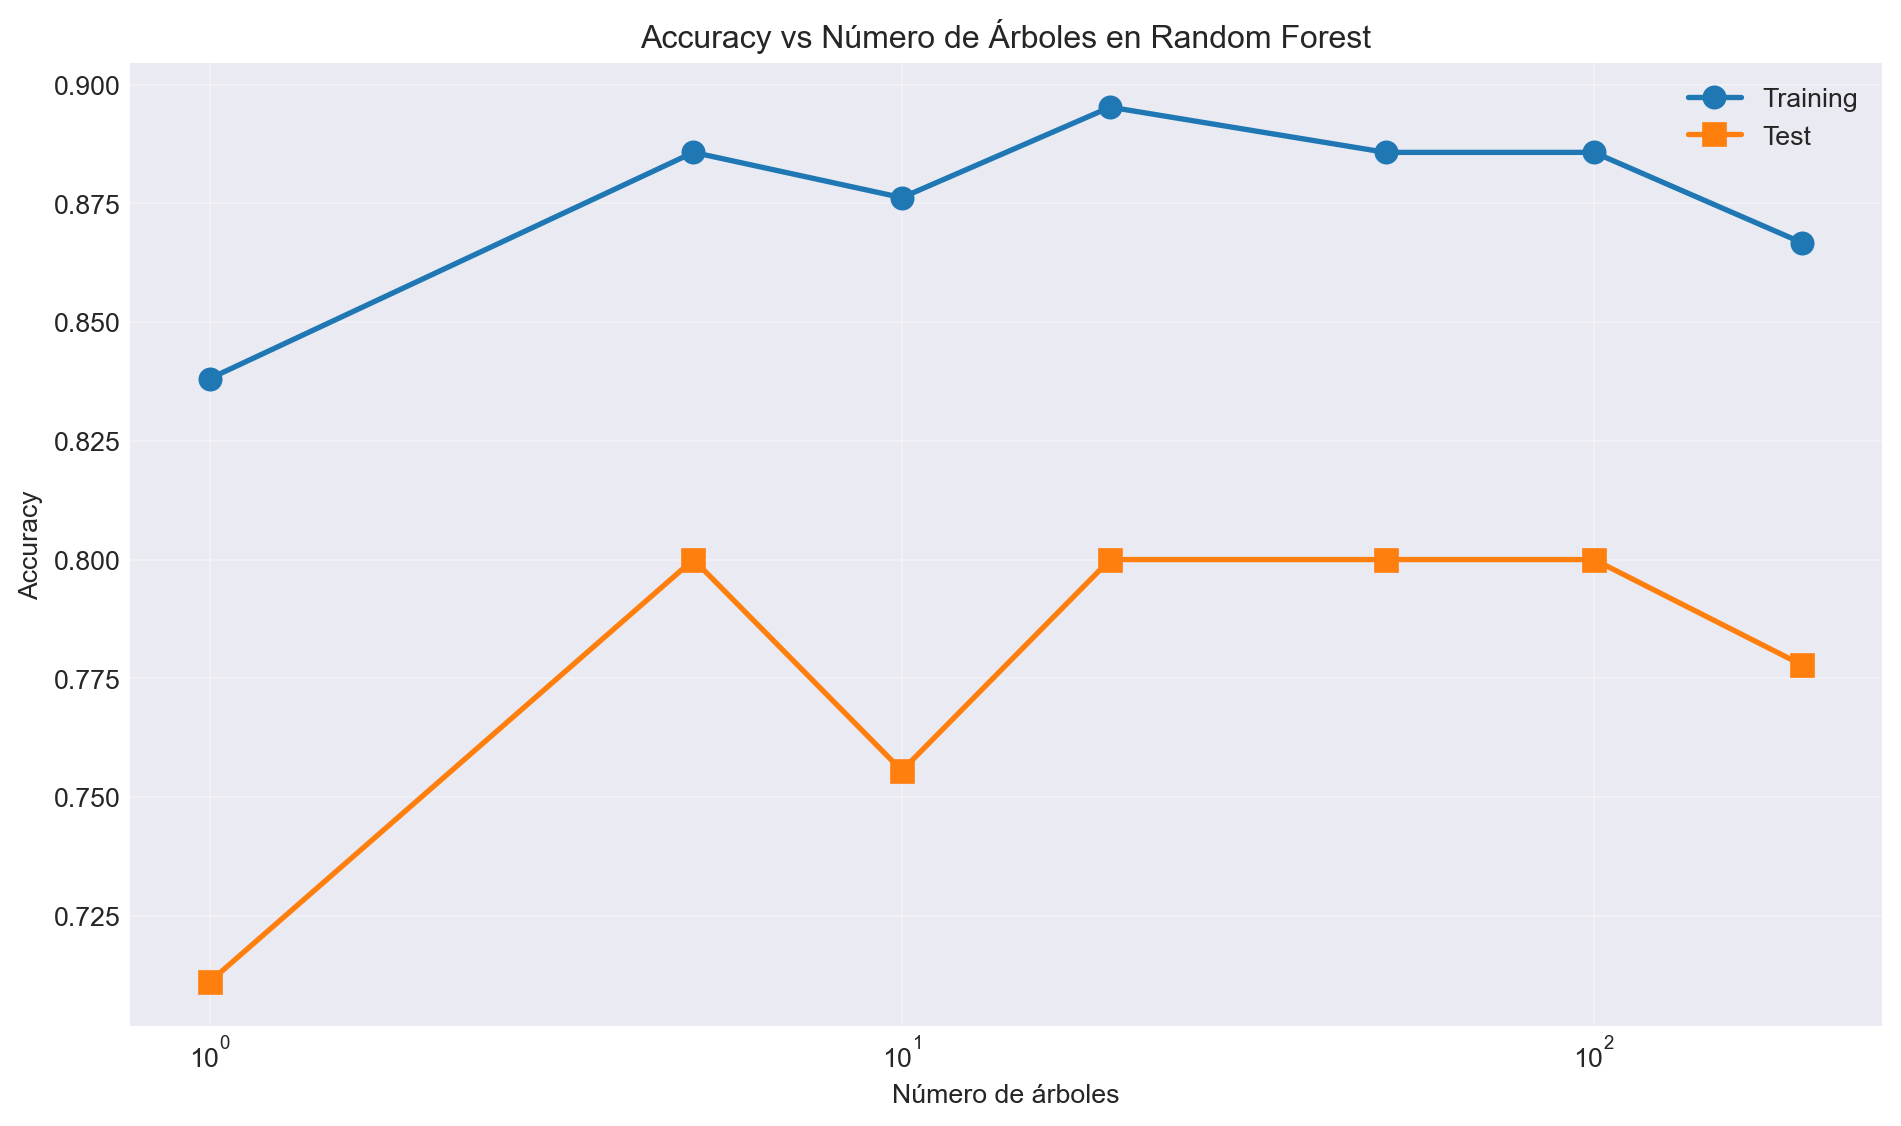
6 Clasificación multi-clase
6.1 Dataset con 3 clases
# Usar todas las especies de Iris (3 clases)
X_multiclass = iris.data[:, :2]
y_multiclass = iris.target

print("CLASIFICACIÓN MULTI-CLASE")
print("=" * 70)
print(f"Número de clases: {len(np.unique(y_multiclass))}")
print(f"Clases: {iris.target_names}")
print(f"\nDistribución:")
for i, nombre in enumerate(iris.target_names):
    count = (y_multiclass == i).sum()
    print(f"  {nombre}: {count} muestras")

# Dividir datos
X_train_mc, X_test_mc, y_train_mc, y_test_mc = train_test_split(
    X_multiclass, y_multiclass, test_size=0.3, random_state=42
)
CLASIFICACIÓN MULTI-CLASE
======================================================================
Número de clases: 3
Clases: ['setosa' 'versicolor' 'virginica']
Distribución:
setosa: 50 muestras
versicolor: 50 muestras
virginica: 50 muestras6.2 Entrenar modelos multi-clase
# Entrenar cada modelo
modelos_mc = {
    'Logistic Regression': LogisticRegression(random_state=42, max_iter=200),
    'KNN': KNeighborsClassifier(n_neighbors=5),
    'Decision Tree': DecisionTreeClassifier(max_depth=5, random_state=42),
    'Random Forest': RandomForestClassifier(n_estimators=100, random_state=42)
}

resultados_mc = {}

print("\n\nRESULTADOS CLASIFICACIÓN MULTI-CLASE")
print("=" * 70)

for nombre, modelo in modelos_mc.items():
    # Entrenar
    modelo.fit(X_train_mc, y_train_mc)

    # Predecir
    y_pred = modelo.predict(X_test_mc)

    # Evaluar
    acc = accuracy_score(y_test_mc, y_pred)

    resultados_mc[nombre] = {
        'modelo': modelo,
        'accuracy': acc
    }

    print(f"\n{nombre}:")
    print(f"  Accuracy: {acc:.4f} ({acc*100:.1f}%)")

    # Matriz de confusión
    cm = confusion_matrix(y_test_mc, y_pred)
    print(f"  Matriz de confusión:")
    print(f"  {cm}")

# Encontrar mejor modelo
mejor_modelo_mc = max(resultados_mc, key=lambda x: resultados_mc[x]['accuracy'])
print(f"\n\nMejor modelo: {mejor_modelo_mc}")
print(f"Accuracy: {resultados_mc[mejor_modelo_mc]['accuracy']:.4f}")
RESULTADOS CLASIFICACIÓN MULTI-CLASE
======================================================================

Logistic Regression:
  Accuracy: 0.8222 (82.2%)
  Matriz de confusión:
  [[19  0  0]
 [ 0  7  6]
 [ 0  2 11]]

KNN:
  Accuracy: 0.7778 (77.8%)
  Matriz de confusión:
  [[19  0  0]
 [ 0  8  5]
 [ 0  5  8]]

Decision Tree:
  Accuracy: 0.7556 (75.6%)
  Matriz de confusión:
  [[18  1  0]
 [ 0  8  5]
 [ 0  5  8]]

Random Forest:
  Accuracy: 0.7556 (75.6%)
  Matriz de confusión:
  [[19  0  0]
 [ 0  7  6]
 [ 0  5  8]]


Mejor modelo: Logistic Regression
Accuracy: 0.8222
6.3 Visualización multi-clase
# Visualizar fronteras de decisión para cada modelo
fig, axes = plt.subplots(2, 2, figsize=(16, 14))
axes = axes.ravel()

h = 0.02
x_min, x_max = X_multiclass[:, 0].min() - 0.5, X_multiclass[:, 0].max() + 0.5
y_min, y_max = X_multiclass[:, 1].min() - 0.5, X_multiclass[:, 1].max() + 0.5
xx, yy = np.meshgrid(np.arange(x_min, x_max, h),
                     np.arange(y_min, y_max, h))

for idx, (nombre, resultado) in enumerate(resultados_mc.items()):
    modelo = resultado['modelo']
    acc = resultado['accuracy']

    # Predecir para malla
    Z = modelo.predict(np.c_[xx.ravel(), yy.ravel()])
    Z = Z.reshape(xx.shape)

    # Graficar
    axes[idx].contourf(xx, yy, Z, alpha=0.4, cmap='viridis')
    scatter = axes[idx].scatter(X_multiclass[:, 0], X_multiclass[:, 1],
                               c=y_multiclass, cmap='viridis',
                               edgecolors='black', s=50)

    axes[idx].set_xlabel('Largo del sépalo (cm)')
    axes[idx].set_ylabel('Ancho del sépalo (cm)')
    axes[idx].set_title(f'{nombre}\nAccuracy={acc:.3f}')
    axes[idx].grid(True, alpha=0.3)

# Leyenda común
plt.colorbar(scatter, ax=axes, label='Especie', ticks=[0, 1, 2])

plt.tight_layout()
plt.savefig('multiclass_comparison.png', dpi=300, bbox_inches='tight')
print("\nComparación guardada como 'multiclass_comparison.png'")
Comparación guardada como 'multiclass_comparison.png'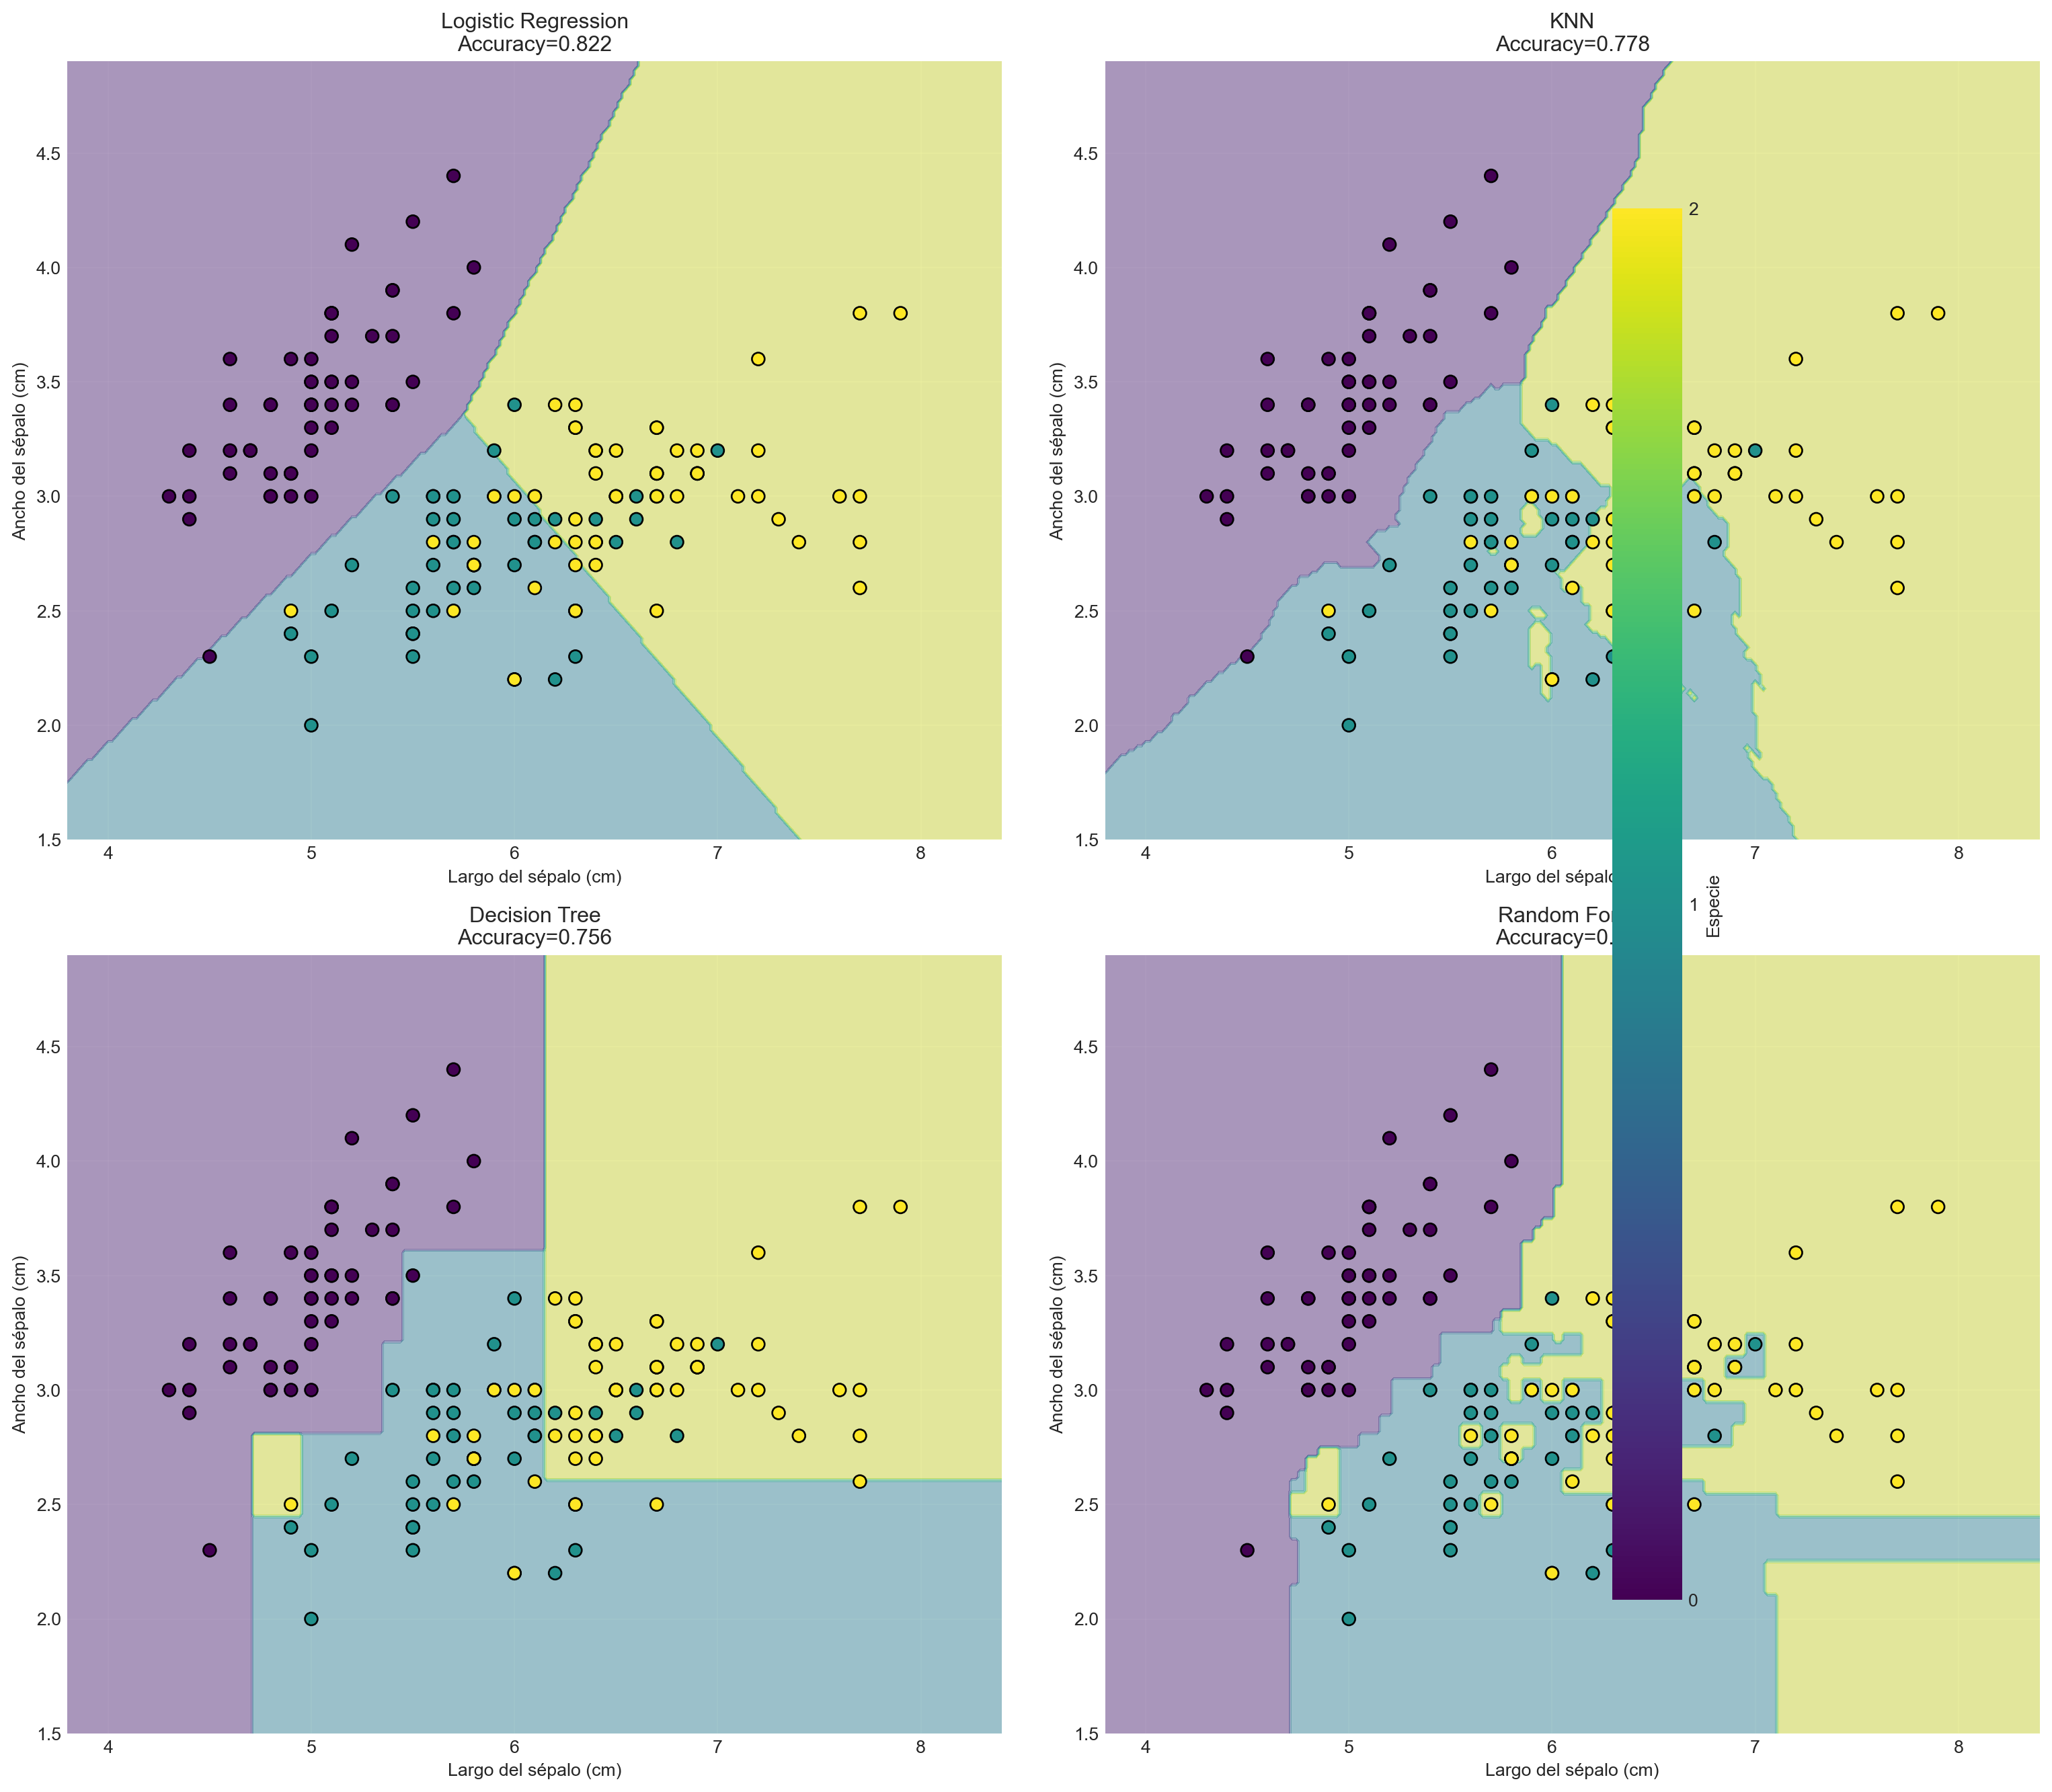
7 Comparación de modelos
7.1 Curvas ROC para cada modelo
# Calcular curvas ROC para clasificación binaria
def calcular_roc_multimodelo(modelos_dict, X_test, y_test):
    """Calcula curvas ROC para múltiples modelos"""

    plt.figure(figsize=(10, 8))

    for nombre, modelo in modelos_dict.items():
        # Obtener probabilidades
        if hasattr(modelo, 'predict_proba'):
            probs = modelo.predict_proba(X_test)[:, 1]
        else:
            probs = modelo.decision_function(X_test)

        # Calcular curva ROC
        fpr, tpr, _ = roc_curve(y_test, probs)
        roc_auc = auc(fpr, tpr)

        # Graficar
        plt.plot(fpr, tpr, linewidth=2,
                label=f'{nombre} (AUC={roc_auc:.3f})')

    # Línea diagonal
    plt.plot([0, 1], [0, 1], 'k--', linewidth=2, label='Azar (AUC=0.5)')

    plt.xlabel('False Positive Rate', fontsize=12)
    plt.ylabel('True Positive Rate', fontsize=12)
    plt.title('Curvas ROC - Comparación de Modelos',
              fontsize=14, fontweight='bold')
    plt.legend(loc='lower right')
    plt.grid(True, alpha=0.3)
    plt.tight_layout()
    plt.savefig('roc_comparison.png', dpi=300, bbox_inches='tight')
    print("Curvas ROC guardadas como 'roc_comparison.png'")

# Preparar modelos para comparación (clasificación binaria)
modelos_binarios = {
    'Logistic Regression': LogisticRegression(random_state=42),
    'KNN (k=5)': KNeighborsClassifier(n_neighbors=5),
    'Decision Tree': DecisionTreeClassifier(max_depth=5, random_state=42),
    'Random Forest': RandomForestClassifier(n_estimators=100, random_state=42)
}

# Entrenar modelos
for modelo in modelos_binarios.values():
    modelo.fit(X_train, y_train)

# Calcular y graficar ROC
calcular_roc_multimodelo(modelos_binarios, X_test, y_test)
Curvas ROC guardadas como 'roc_comparison.png'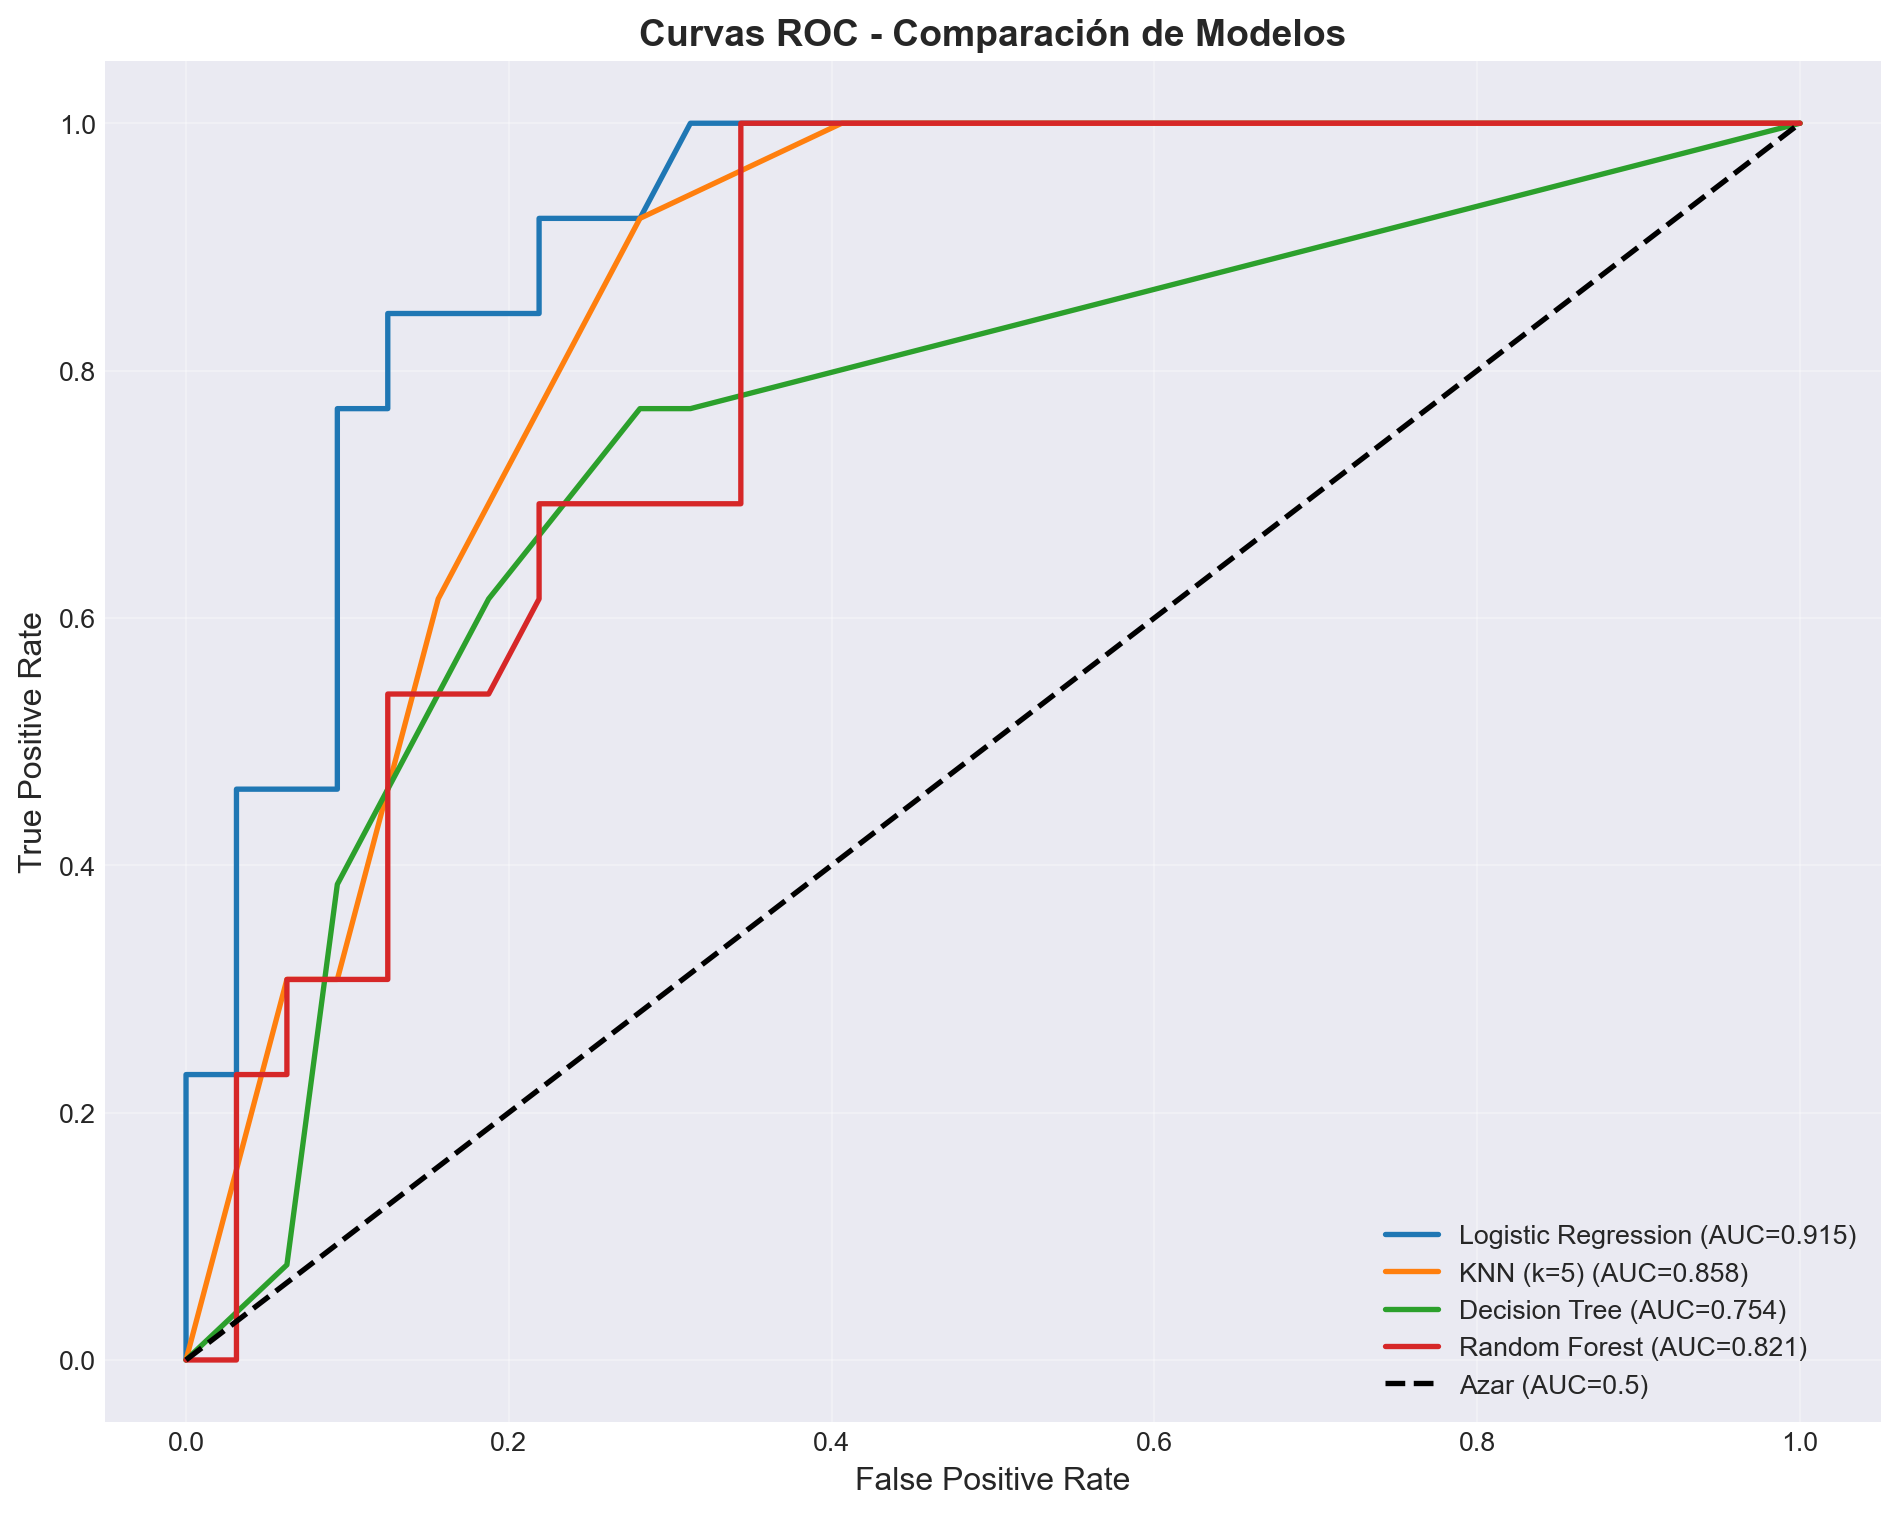
7.2 Tabla comparativa de métricas
# Compilar todas las métricas
print("\n\nTABLA COMPARATIVA DE MODELOS")
print("=" * 70)

resultados_comparacion = []

for nombre, modelo in modelos_binarios.items():
    # Predicciones
    y_pred = modelo.predict(X_test)

    # Probabilidades
    if hasattr(modelo, 'predict_proba'):
        probs = modelo.predict_proba(X_test)[:, 1]
    else:
        probs = modelo.decision_function(X_test)

    # Métricas
    from sklearn.metrics import precision_score, recall_score, f1_score

    acc = accuracy_score(y_test, y_pred)
    precision = precision_score(y_test, y_pred)
    recall = recall_score(y_test, y_pred)
    f1 = f1_score(y_test, y_pred)

    # ROC AUC
    fpr, tpr, _ = roc_curve(y_test, probs)
    roc_auc = auc(fpr, tpr)

    resultados_comparacion.append({
        'Modelo': nombre,
        'Accuracy': acc,
        'Precision': precision,
        'Recall': recall,
        'F1-Score': f1,
        'AUC': roc_auc
    })

# Crear DataFrame
df_comparacion = pd.DataFrame(resultados_comparacion)
df_comparacion = df_comparacion.round(4)

print(df_comparacion.to_string(index=False))

# Guardar
df_comparacion.to_csv('comparacion_modelos.csv', index=False)
print("\n\nTabla guardada como 'comparacion_modelos.csv'")
TABLA COMPARATIVA DE MODELOS
======================================================================
             Modelo  Accuracy  Precision  Recall  F1-Score    AUC
Logistic Regression    0.8667     0.7333  0.8462    0.7857 0.9147
          KNN (k=5)    0.7778     0.6154  0.6154    0.6154 0.8582
      Decision Tree    0.7556     0.6250  0.3846    0.4762 0.7536
      Random Forest    0.7333     0.5385  0.5385    0.5385 0.8209


Tabla guardada como 'comparacion_modelos.csv'
8 Aplicaciones económicas
8.1 Aplicación 1: Clasificación de riesgo crediticio
print("\n\n\nAPLICACIÓN: CLASIFICACIÓN DE RIESGO CREDITICIO")
print("=" * 70)

# Generar datos sintéticos
np.random.seed(42)
n_clientes = 2000

datos_credito = pd.DataFrame({
    'edad': np.random.randint(18, 70, n_clientes),
    'ingreso_anual': np.random.uniform(10000, 150000, n_clientes),
    'monto_solicitado': np.random.uniform(5000, 200000, n_clientes),
    'antiguedad_laboral': np.random.randint(0, 30, n_clientes),
    'num_creditos_previos': np.random.randint(0, 10, n_clientes),
    'ratio_deuda_ingreso': np.random.uniform(0, 1.5, n_clientes),
    'tiene_hipoteca': np.random.choice([0, 1], n_clientes),
    'score_crediticio': np.random.randint(300, 850, n_clientes)
})

# Variable objetivo: riesgo (0=bajo, 1=medio, 2=alto)
score_riesgo = (
    -datos_credito['score_crediticio'] * 0.003 +
    datos_credito['ratio_deuda_ingreso'] * 2 +
    -datos_credito['antiguedad_laboral'] * 0.05 +
    datos_credito['num_creditos_previos'] * 0.2 +
    np.random.normal(0, 0.5, n_clientes)
)

# Clasificar en 3 niveles
datos_credito['riesgo'] = pd.cut(
    score_riesgo,
    bins=3,
    labels=['Bajo', 'Medio', 'Alto']
)

# Convertir a numérico
datos_credito['riesgo_num'] = datos_credito['riesgo'].map({
    'Bajo': 0,
    'Medio': 1,
    'Alto': 2
})

print(f"\nDataset de crédito:")
print(f"  Total clientes: {n_clientes:,}")
print(f"\nDistribución de riesgo:")
print(datos_credito['riesgo'].value_counts())

# Preparar datos
X_credito = datos_credito.drop(['riesgo', 'riesgo_num'], axis=1)
y_credito = datos_credito['riesgo_num']

X_train_cr, X_test_cr, y_train_cr, y_test_cr = train_test_split(
    X_credito, y_credito, test_size=0.3, random_state=42, stratify=y_credito
)

# Estandarizar
scaler_credito = StandardScaler()
X_train_cr_scaled = scaler_credito.fit_transform(X_train_cr)
X_test_cr_scaled = scaler_credito.transform(X_test_cr)

# Entrenar modelos
print("\n\nENTRENAMIENTO DE MODELOS")
print("=" * 70)

modelos_credito = {
    'Random Forest': RandomForestClassifier(n_estimators=200, max_depth=10, random_state=42),
    'Decision Tree': DecisionTreeClassifier(max_depth=8, random_state=42),
    'KNN': KNeighborsClassifier(n_neighbors=10),
    'Logistic Regression': LogisticRegression(max_iter=1000, random_state=42)
}

for nombre, modelo in modelos_credito.items():
    # Entrenar
    if nombre in ['KNN', 'Logistic Regression']:
        modelo.fit(X_train_cr_scaled, y_train_cr)
        y_pred = modelo.predict(X_test_cr_scaled)
    else:
        modelo.fit(X_train_cr, y_train_cr)
        y_pred = modelo.predict(X_test_cr)

    # Evaluar
    acc = accuracy_score(y_test_cr, y_pred)

    print(f"\n{nombre}:")
    print(f"  Accuracy: {acc:.4f} ({acc*100:.1f}%)")

    # Reporte por clase
    print(f"\n  Reporte de clasificación:")
    print(classification_report(
        y_test_cr, y_pred,
        target_names=['Bajo', 'Medio', 'Alto'],
        digits=3
    ))

# Importancia de características (Random Forest)
print("\n\nIMPORTANCIA DE CARACTERÍSTICAS (Random Forest)")
print("=" * 70)

rf_final = modelos_credito['Random Forest']
importancias = pd.DataFrame({
    'caracteristica': X_credito.columns,
    'importancia': rf_final.feature_importances_
}).sort_values('importancia', ascending=False)

for _, row in importancias.iterrows():
    print(f"  {row['caracteristica']:<25} {row['importancia']:.4f} {'█' * int(row['importancia'] * 100)}")
APLICACIÓN: CLASIFICACIÓN DE RIESGO CREDITICIO
======================================================================

Dataset de crédito:
  Total clientes: 2,000

Distribución de riesgo:
riesgo
Medio    1406
Bajo      399
Alto      195
Name: count, dtype: int64


ENTRENAMIENTO DE MODELOS
======================================================================

Random Forest:
  Accuracy: 0.8217 (82.2%)

  Reporte de clasificación:
              precision    recall  f1-score   support

        Bajo      0.828     0.600     0.696       120
       Medio      0.819     0.957     0.883       422
        Alto      0.850     0.293     0.436        58

    accuracy                          0.822       600
   macro avg      0.832     0.617     0.672       600
weighted avg      0.824     0.822     0.802       600


Decision Tree:
  Accuracy: 0.7967 (79.7%)

  Reporte de clasificación:
              precision    recall  f1-score   support

        Bajo      0.694     0.717     0.705       120
       Medio      0.841     0.879     0.860       422
        Alto      0.600     0.362     0.452        58

    accuracy                          0.797       600
   macro avg      0.712     0.653     0.672       600
weighted avg      0.788     0.797     0.789       600


KNN:
  Accuracy: 0.8150 (81.5%)

  Reporte de clasificación:
              precision    recall  f1-score   support

        Bajo      0.779     0.617     0.688       120
       Medio      0.818     0.948     0.878       422
        Alto      0.938     0.259     0.405        58

    accuracy                          0.815       600
   macro avg      0.845     0.608     0.657       600
weighted avg      0.822     0.815     0.794       600


Logistic Regression:
  Accuracy: 0.8600 (86.0%)

  Reporte de clasificación:
              precision    recall  f1-score   support

        Bajo      0.823     0.775     0.798       120
       Medio      0.876     0.934     0.904       422
        Alto      0.784     0.500     0.611        58

    accuracy                          0.860       600
   macro avg      0.827     0.736     0.771       600
weighted avg      0.856     0.860     0.854       600


IMPORTANCIA DE CARACTERÍSTICAS (Random Forest)
======================================================================
  ratio_deuda_ingreso       0.3181 ███████████████████████████████
  score_crediticio          0.1543 ███████████████
  num_creditos_previos      0.1495 ██████████████
  antiguedad_laboral        0.1171 ███████████
  monto_solicitado          0.0876 ████████
  ingreso_anual             0.0861 ████████
  edad                      0.0739 ███████
  tiene_hipoteca            0.0134 █
8.2 Aplicación 2: Segmentación de clientes
print("\n\n\nAPLICACIÓN: SEGMENTACIÓN DE CLIENTES")
print("=" * 70)

# Generar datos de clientes
np.random.seed(42)
n_clientes_seg = 1500

datos_clientes = pd.DataFrame({
    'edad': np.random.randint(18, 80, n_clientes_seg),
    'ingreso_mensual': np.random.uniform(1000, 20000, n_clientes_seg),
    'gasto_mensual': np.random.uniform(500, 15000, n_clientes_seg),
    'num_compras_mes': np.random.randint(0, 30, n_clientes_seg),
    'antiguedad_meses': np.random.randint(1, 120, n_clientes_seg),
    'ticket_promedio': np.random.uniform(20, 500, n_clientes_seg),
    'visitas_web': np.random.randint(0, 100, n_clientes_seg)
})

# Calcular características adicionales
datos_clientes['frecuencia_compra'] = datos_clientes['num_compras_mes'] / 4
datos_clientes['ratio_gasto_ingreso'] = datos_clientes['gasto_mensual'] / datos_clientes['ingreso_mensual']

# Crear segmentos (0=Bronce, 1=Plata, 2=Oro, 3=Platino)
score_valor = (
    datos_clientes['gasto_mensual'] * 0.0003 +
    datos_clientes['num_compras_mes'] * 0.1 +
    datos_clientes['ticket_promedio'] * 0.005 +
    np.random.normal(0, 0.3, n_clientes_seg)
)

datos_clientes['segmento'] = pd.cut(
    score_valor,
    bins=4,
    labels=['Bronce', 'Plata', 'Oro', 'Platino']
)

datos_clientes['segmento_num'] = datos_clientes['segmento'].map({
    'Bronce': 0,
    'Plata': 1,
    'Oro': 2,
    'Platino': 3
})

print(f"\nDistribución de segmentos:")
print(datos_clientes['segmento'].value_counts().sort_index())

# Preparar datos
features_seg = ['edad', 'ingreso_mensual', 'gasto_mensual', 'num_compras_mes',
                'antiguedad_meses', 'ticket_promedio', 'visitas_web',
                'frecuencia_compra', 'ratio_gasto_ingreso']

X_seg = datos_clientes[features_seg]
y_seg = datos_clientes['segmento_num']

X_train_seg, X_test_seg, y_train_seg, y_test_seg = train_test_split(
    X_seg, y_seg, test_size=0.3, random_state=42, stratify=y_seg
)

# Entrenar Random Forest (mejor modelo típicamente)
print("\n\nMODELO DE SEGMENTACIÓN")
print("=" * 70)

rf_segmentacion = RandomForestClassifier(
    n_estimators=200,
    max_depth=12,
    min_samples_split=20,
    random_state=42
)

rf_segmentacion.fit(X_train_seg, y_train_seg)

# Evaluar
y_pred_seg = rf_segmentacion.predict(X_test_seg)
acc_seg = accuracy_score(y_test_seg, y_pred_seg)

print(f"Accuracy: {acc_seg:.4f} ({acc_seg*100:.1f}%)")

# Matriz de confusión
cm_seg = confusion_matrix(y_test_seg, y_pred_seg)
print(f"\nMatriz de confusión:")
print(f"                    Predicho")
print(f"             Bronce  Plata   Oro  Platino")
print(f"Real Bronce    {cm_seg[0, 0]:4d}   {cm_seg[0, 1]:4d}  {cm_seg[0, 2]:4d}    {cm_seg[0, 3]:4d}")
print(f"     Plata     {cm_seg[1, 0]:4d}   {cm_seg[1, 1]:4d}  {cm_seg[1, 2]:4d}    {cm_seg[1, 3]:4d}")
print(f"     Oro       {cm_seg[2, 0]:4d}   {cm_seg[2, 1]:4d}  {cm_seg[2, 2]:4d}    {cm_seg[2, 3]:4d}")
print(f"     Platino   {cm_seg[3, 0]:4d}   {cm_seg[3, 1]:4d}  {cm_seg[3, 2]:4d}    {cm_seg[3, 3]:4d}")

# Características más importantes
print(f"\n\nCARACTERÍSTICAS MÁS IMPORTANTES PARA SEGMENTACIÓN")
print("=" * 70)

importancias_seg = pd.DataFrame({
    'caracteristica': features_seg,
    'importancia': rf_segmentacion.feature_importances_
}).sort_values('importancia', ascending=False)

for _, row in importancias_seg.iterrows():
    barra = '█' * int(row['importancia'] * 100)
    print(f"  {row['caracteristica']:<25} {row['importancia']:.4f} {barra}")

print(f"\n\nAPLICACIÓN PRÁCTICA:")
print("Este modelo permite:")
print("  1. Clasificar automáticamente nuevos clientes")
print("  2. Personalizar ofertas según segmento")
print("  3. Identificar clientes con potencial de upgrade")
print("  4. Optimizar estrategias de retención")
APLICACIÓN: SEGMENTACIÓN DE CLIENTES
======================================================================

Distribución de segmentos:
segmento
Bronce     129
Plata      548
Oro        635
Platino    188
Name: count, dtype: int64


MODELO DE SEGMENTACIÓN
======================================================================
Accuracy: 0.8489 (84.9%)

Matriz de confusión:
                    Predicho
             Bronce  Plata   Oro  Platino
Real Bronce      20     19     0       0
     Plata        1    147    16       0
     Oro          0     10   180       1
     Platino      0      0    21      35


CARACTERÍSTICAS MÁS IMPORTANTES PARA SEGMENTACIÓN
======================================================================
  gasto_mensual             0.3186 ███████████████████████████████
  ticket_promedio           0.2043 ████████████████████
  num_compras_mes           0.1317 █████████████
  frecuencia_compra         0.1266 ████████████
  ratio_gasto_ingreso       0.1147 ███████████
  ingreso_mensual           0.0321 ███
  antiguedad_meses          0.0271 ██
  visitas_web               0.0229 ██
  edad                      0.0220 ██


APLICACIÓN PRÁCTICA:
Este modelo permite:
  1. Clasificar automáticamente nuevos clientes
  2. Personalizar ofertas según segmento
  3. Identificar clientes con potencial de upgrade
  4. Optimizar estrategias de retención
9 Ejercicios prácticos
9.1 Ejercicio: Optimización de hiperparámetros
print("\n\n\nEJERCICIO: OPTIMIZACIÓN DE HIPERPARÁMETROS")
print("=" * 70)

# Grid search manual para Random Forest
param_grid = {
    'n_estimators': [50, 100, 200],
    'max_depth': [5, 10, 15, None],
    'min_samples_split': [2, 10, 20]
}

mejores_params = None
mejor_score = 0

print("\nBuscando mejores hiperparámetros...")
print(f"Total combinaciones: {len(param_grid['n_estimators']) * len(param_grid['max_depth']) * len(param_grid['min_samples_split'])}")

resultados_grid = []

for n_est in param_grid['n_estimators']:
    for max_d in param_grid['max_depth']:
        for min_split in param_grid['min_samples_split']:

            # Entrenar modelo
            rf = RandomForestClassifier(
                n_estimators=n_est,
                max_depth=max_d,
                min_samples_split=min_split,
                random_state=42
            )

            # Validación cruzada
            scores = cross_val_score(rf, X_train, y_train, cv=5)
            score_mean = scores.mean()

            resultados_grid.append({
                'n_estimators': n_est,
                'max_depth': max_d if max_d else 'None',
                'min_samples_split': min_split,
                'cv_score': score_mean
            })

            if score_mean > mejor_score:
                mejor_score = score_mean
                mejores_params = {
                    'n_estimators': n_est,
                    'max_depth': max_d,
                    'min_samples_split': min_split
                }

print(f"\n\nMEJORES HIPERPARÁMETROS")
print("=" * 70)
print(f"  n_estimators: {mejores_params['n_estimators']}")
print(f"  max_depth: {mejores_params['max_depth']}")
print(f"  min_samples_split: {mejores_params['min_samples_split']}")
print(f"  CV Score: {mejor_score:.4f}")

# Entrenar modelo final
rf_optimo = RandomForestClassifier(**mejores_params, random_state=42)
rf_optimo.fit(X_train, y_train)

acc_optimo = rf_optimo.score(X_test, y_test)
print(f"\nAccuracy en test: {acc_optimo:.4f} ({acc_optimo*100:.1f}%)")

# Top 10 combinaciones
df_grid = pd.DataFrame(resultados_grid).sort_values('cv_score', ascending=False)
print(f"\n\nTop 10 combinaciones:")
print(df_grid.head(10).to_string(index=False))
EJERCICIO: OPTIMIZACIÓN DE HIPERPARÁMETROS
======================================================================

Buscando mejores hiperparámetros...
Total combinaciones: 36


MEJORES HIPERPARÁMETROS
======================================================================
  n_estimators: 100
  max_depth: 5
  min_samples_split: 10
  CV Score: 0.8190

Accuracy en test: 0.8000 (80.0%)


Top 10 combinaciones:
 n_estimators max_depth  min_samples_split  cv_score
          100         5                 10  0.819048
          200         5                 10  0.809524
           50         5                 20  0.800000
           50        15                 10  0.800000
          100        15                 10  0.800000
          200        15                 10  0.800000
          100      None                 10  0.800000
           50        10                 10  0.800000
           50      None                 20  0.800000
           50      None                 10  0.800000
10 Conclusión
En esta guía hemos explorado los principales algoritmos de clasificación:
Regresión Logística
Modelo lineal simple y rápido. Usa función sigmoide para probabilidades. Interpretable. Bueno como baseline.
K-Nearest Neighbors (KNN)
No paramétrico. Clasifica según vecinos más cercanos. Sensible a escala. Bueno para fronteras complejas.
Árboles de Decisión
Reglas interpretables. No requiere normalización. Propenso a overfitting. Base para métodos ensemble.
Random Forests
Ensemble de árboles. Reduce overfitting. Alta precisión. Menos interpretable que árbol único.
Comparación de modelos
Importancia de evaluar múltiples algoritmos. Usar validación cruzada. Considerar trade-offs interpretabilidad vs precisión.
11 Próximos pasos
En la siguiente guía (Guía 10: Métodos de ML para Regresión) exploraremos:
- Regresión lineal
- Ridge y Lasso
- Regresión polinomial
- Métricas: R², MSE, MAE
- Aplicaciones económicas
12 Recursos adicionales
Para profundizar en clasificación:
- Scikit-learn Documentation: scikit-learn.org
- Introduction to Statistical Learning (ISLR)
- Hands-On Machine Learning (Aurélien Géron)
- Papers en credit scoring y risk management
Cómo citar
Achalma, E. (2021, 6 de diciembre). Métodos de Machine Learning para Clasificación. Numerus Scriptum. https://numerus-scriptum.netlify.app/cursos/python/metodos-de-machine-learning-para-clasificacion-con-python/